先用一句話抓住這篇
十二張漫畫從資料搬移、reticle stitching 與缺陷容忍,講到片上 SRAM、dataflow、CSoft、CS-4、prefill/decode,以及 Cerebras、GPU、Taalas 的架構取捨。
先把這篇當成一張閱讀地圖:上方摘要說明問題,圖片先建立直覺,下面文字再補上真正的技術取捨。
如果第一次讀覺得名詞很多,可以先記住比喻與結論;第二次再回頭看名詞,會順很多。
想像一座 AI 校園:教室負責計算,白板暫放資料,道路負責把資料送到下一間教室。教室再多、算得再快,如果每一題都得跑到校外倉庫拿課本,大家還是只能排隊等資料。Cerebras 的出發點,就是把更多「教室、白板與道路」留在同一片晶圓上。
這不代表晶圓越大就一定越快,更不是把所有問題一次消滅。接下來十二張漫畫會反覆追問兩件事:「資料放在哪裡?」以及「它要走多遠?」沿著這兩個問題,我們會看懂光刻拼接、壞點繞路、分散式 SRAM、資料流編程、多晶圓系統,以及 Cerebras、GPU、Taalas 各自把成本放在哪裡。
1. AI 為什麼常常卡在搬資料?
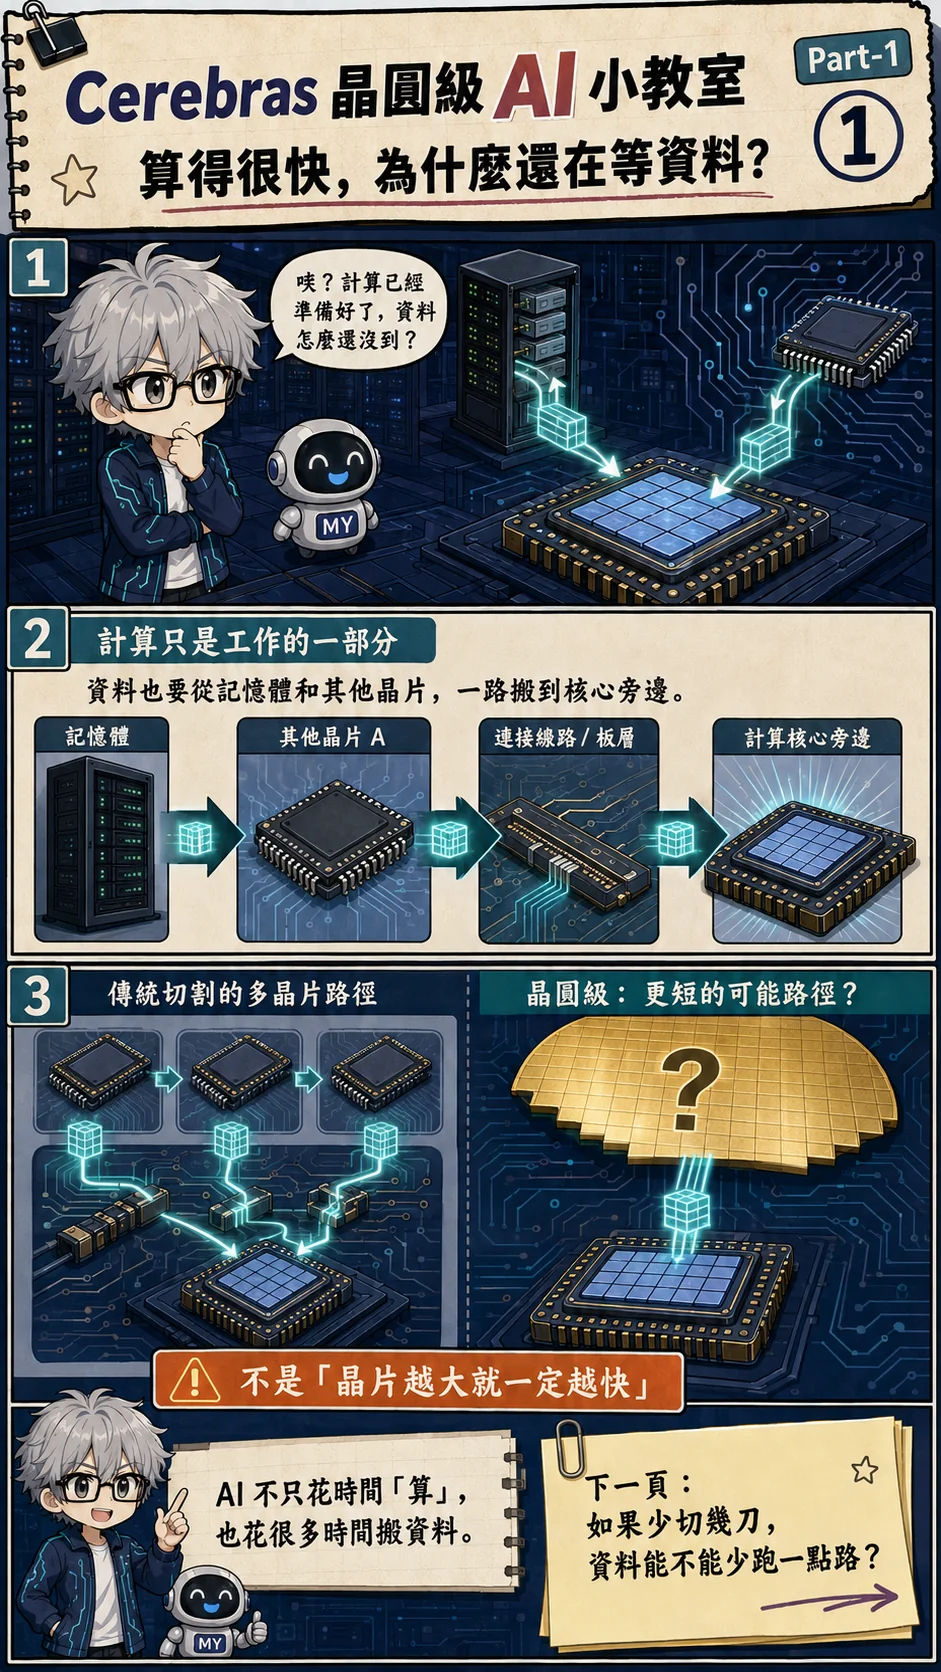
把 AI 想成一班正在解題的學生。計算單元像學生的大腦;模型權重像解題規則,輸入是題目,activation 是做到一半的草稿,KV cache 則是對話中已經整理好的筆記。少了任何一份資料,學生心算再快也只能先等。
評估一套 AI 硬體,至少要分開看四件事。運算量是學生一秒能算幾題;容量是教室和倉庫能放多少教材;頻寬像道路同時能通過幾台車;延遲則是第一台車從出發到抵達要多久。道路很寬,不代表第一台車一定立刻到;第一台車很快到,也不代表後面能一次運很多箱。
有些工作是 compute-bound,真的缺算術能力;另一些工作則是 movement-bound,算術單元常在等資料。大型模型會搬動權重、activation、梯度、optimizer state 或 KV cache,哪一項是瓶頸,要看訓練或推論階段、模型形狀、batch 與資料擺放。
真正的硬體裡,資料每跨過一次晶片、封裝、電路板或機櫃邊界,通常就多一段收發、協定、能量與排程成本。Cerebras 把大量小型處理核心、分散式 SRAM 和互連網路放在同一片晶圓上,目的就是縮短其中一部分路程。[1]
主機、外部儲存、網路與 I/O 並沒有因此消失。判斷架構時,別只問「晶圓多大」,而要問:現在搬的是什麼?它原本在哪裡?少跨了哪些邊界?省下的等待,是否大過新增的系統成本?
2. 為什麼不把晶圓切開?
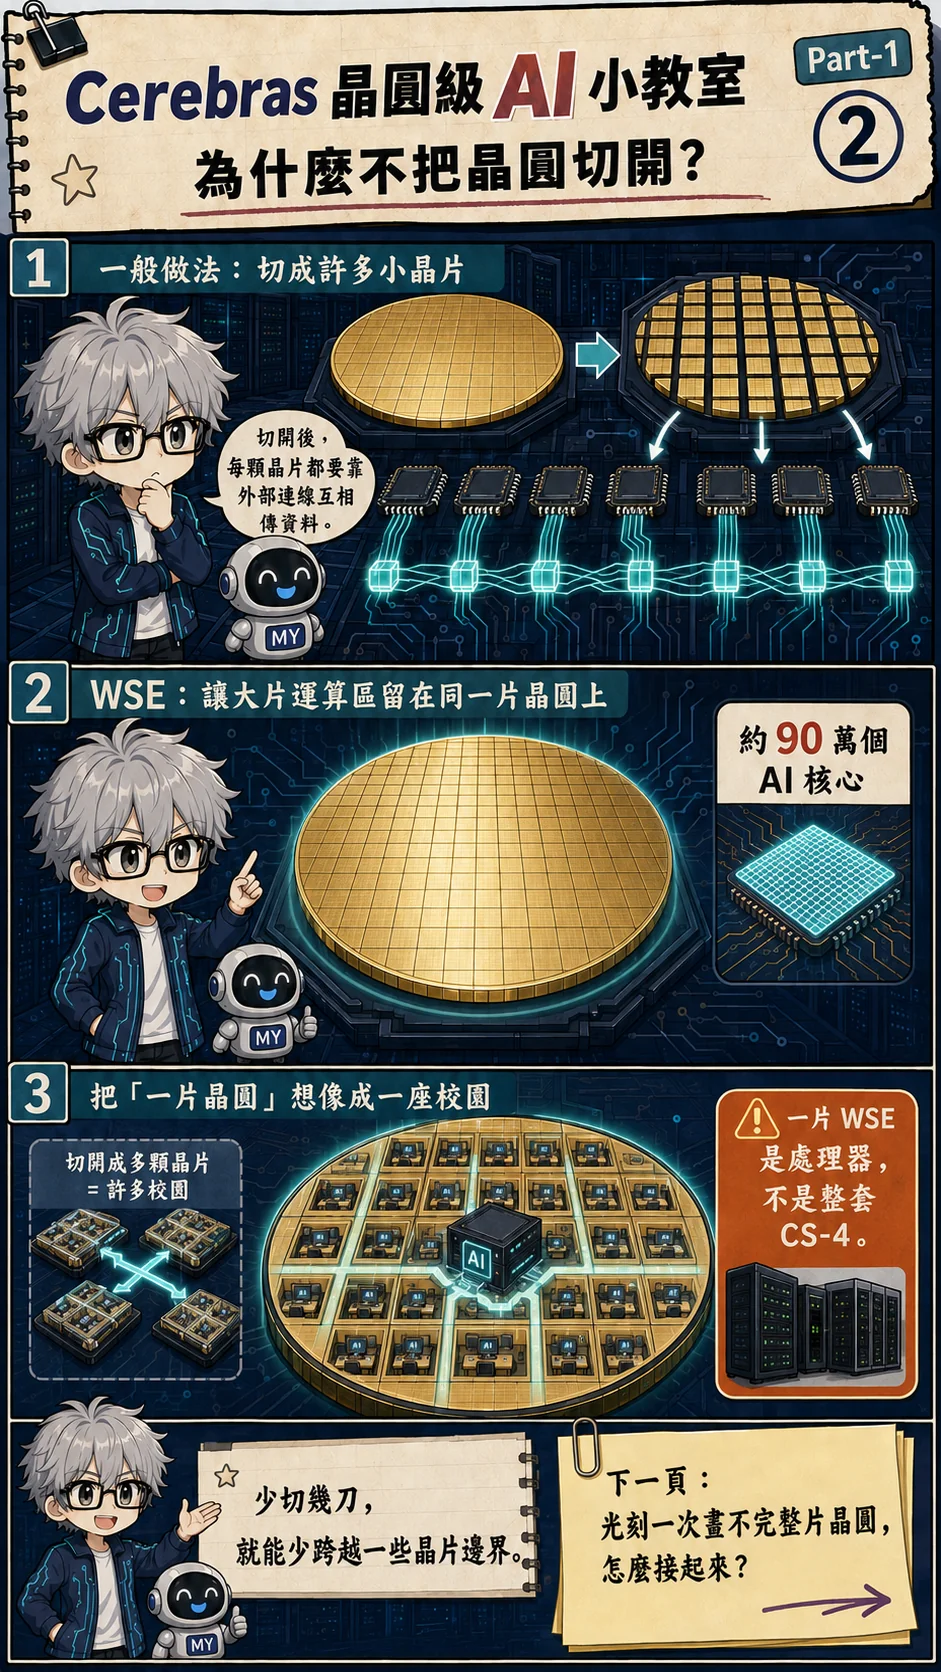
一般晶圓製造完成後,會切成一顆顆 die。每顆 die 先進封裝,再上電路板;需要更多算力時,還可能跨加速器、伺服器與機櫃連線。這些邊界讓產品容易組合與替換,卻也讓資料走得更遠。
Wafer-Scale Engine(WSE)反其道而行:主要運算區不切開,讓大量核心直接在同一片矽上溝通。它省下的是一部分 die-to-die、package-to-package 的旅程,不是把整座資料中心塞進一片晶圓。
這裡的 WSE-3T 是「引擎」,不是整台機器。單片官方規格為 46,225 mm²、4 兆個電晶體、約 90 萬個 AI 核心與 44 GB 片上 SRAM。[1]
CS-4 才是可以部署的完整系統:它整合三片 WSE-3T,以及供電、液冷、控制和 I/O。[2] 所以看到規格表時,第一步要先看清楚單位寫的是「每片晶圓」還是「整套系統」。
晶圓不切開,少了一些通訊邊界,卻新增大型矽的製造、測試、供電、散熱和維修難題。Cerebras 的核心不只是「做一顆超大晶片」,而是把晶片、封裝、系統與軟體一起設計,讓這條路真的能用。
3. 光刻一次畫不完整片晶圓,怎麼辦?
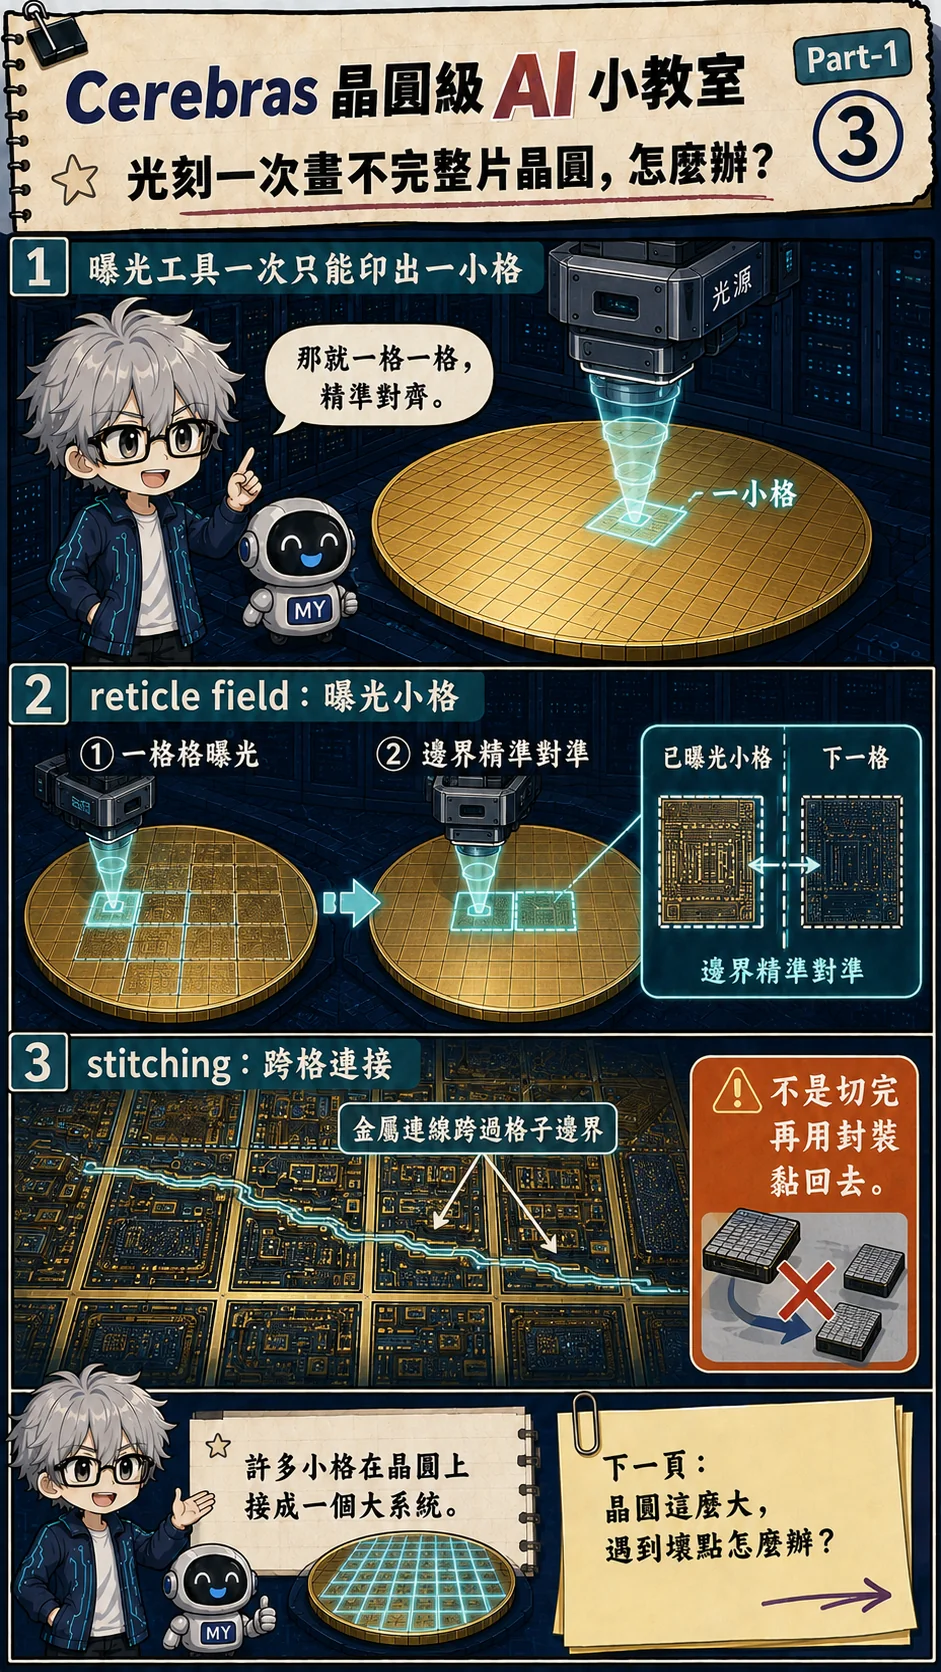
晶片圖案不是一次把整片晶圓「照相」完成。光罩承載電路圖樣,步進式曝光設備會移動到不同位置,一格一格重複曝光;單次能處理的範圍,就是 reticle field。
一般晶片的設計通常留在一個 field 內,之後把 die 切下來。WSE 想跨過這個尺寸限制,就必須讓相鄰 field 邊界上的金屬線能精準接續,這就是 reticle stitching 的核心。
漫畫把它畫成磁磚拼接,但真正要對準的是電路連線。每一格的位置、跨界導線與製程誤差都要事先納入設計;只要邊界沒接好,整片的資料路徑就可能中斷。
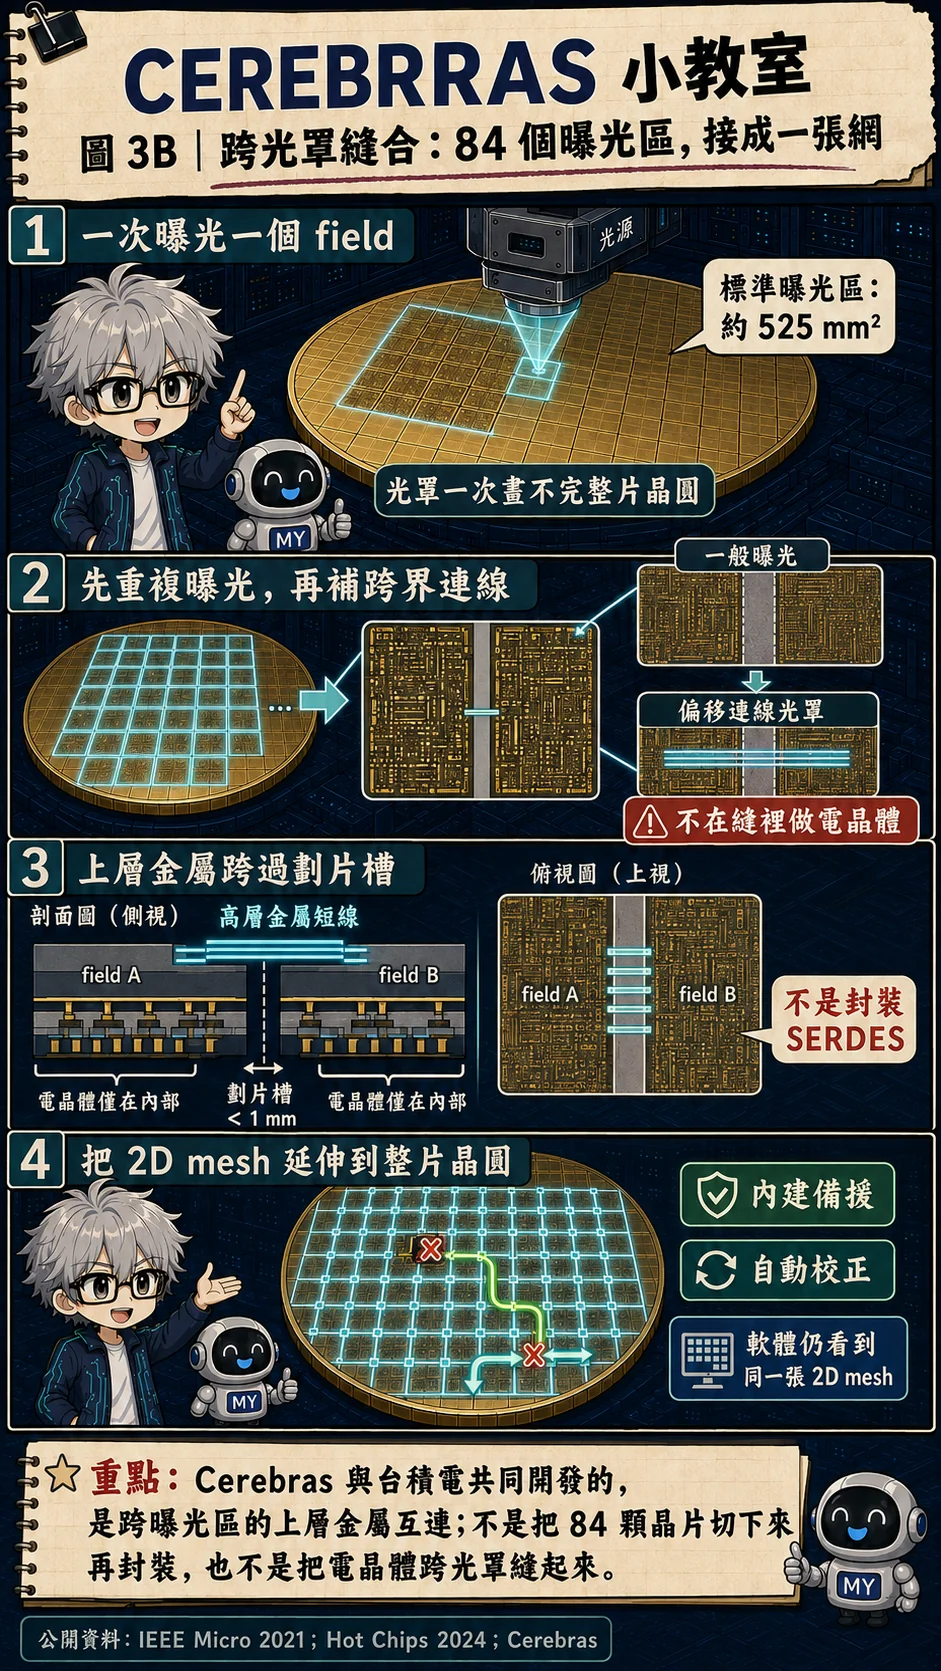
公開的 IEEE Micro 技術文章把流程說得很具體:WSE-2 先用約 525 mm² 的標準光罩,像一般製程那樣逐格曝光;接著再用位置偏移的連線光罩,專門曝光相鄰區域之間的 wiring。這一輪額外曝光只做上層互連金屬,不製作電晶體等主動電路。[7]
Cerebras 的架構說明則補上電氣面:連線跨過不到 1 mm 的劃片槽,使用台積電製程中的高層金屬,並以短距離、平行、source-synchronous 介面延伸 die 內的二維網格。到了整片晶圓,這些跨界線合計超過一百萬條,因此協定也要有訓練與自動校正。[8]
Hot Chips 2024 的 WSE-3 資料把 84 個 die 區畫成同一片 fabric,並說明跨區互連已與台積電合作延伸到 5 nm。這裡的「84 個 die」比較像 84 個留在晶圓上的曝光與設計區域:它們沒有被切開、個別封裝,再經由電路板或封裝 SERDES 相連。[9]
Stitching 也不等於晶圓必須零缺陷。WSE 的 fabric 內建備援,能停用故障核心或連線,再把路徑繞開;軟體最後仍看到規則的二維網格。縫合解決「跨曝光區怎麼連」,備援才處理「有些地方壞了怎麼繼續跑」,兩件事缺一不可。[9]
Stitching 和 chiplet 的差別在「何時、在哪裡連」。Stitching 是晶圓還沒切開時,在矽與金屬層上跨曝光區連接;chiplet 則是把多顆獨立 die 透過封裝互連組成系統。兩者都能擴大系統,但連線距離、密度、測試與維修方式不同。
因此,能跨 field 只是起點。設計團隊還要處理跨區時序、供電、測試存取與多層金屬佈線,確保整片電路不只「連得到」,還能準時、穩定地工作。
工程師延伸:stitching 是實體設計契約
跨 reticle 連線要同時處理曝光邊界對準、金屬佈線、clock/power distribution、timing closure、測試存取與良率。方格規則,不代表 physical closure 只是複製貼上。
4. 晶圓有壞點,為什麼還能工作?
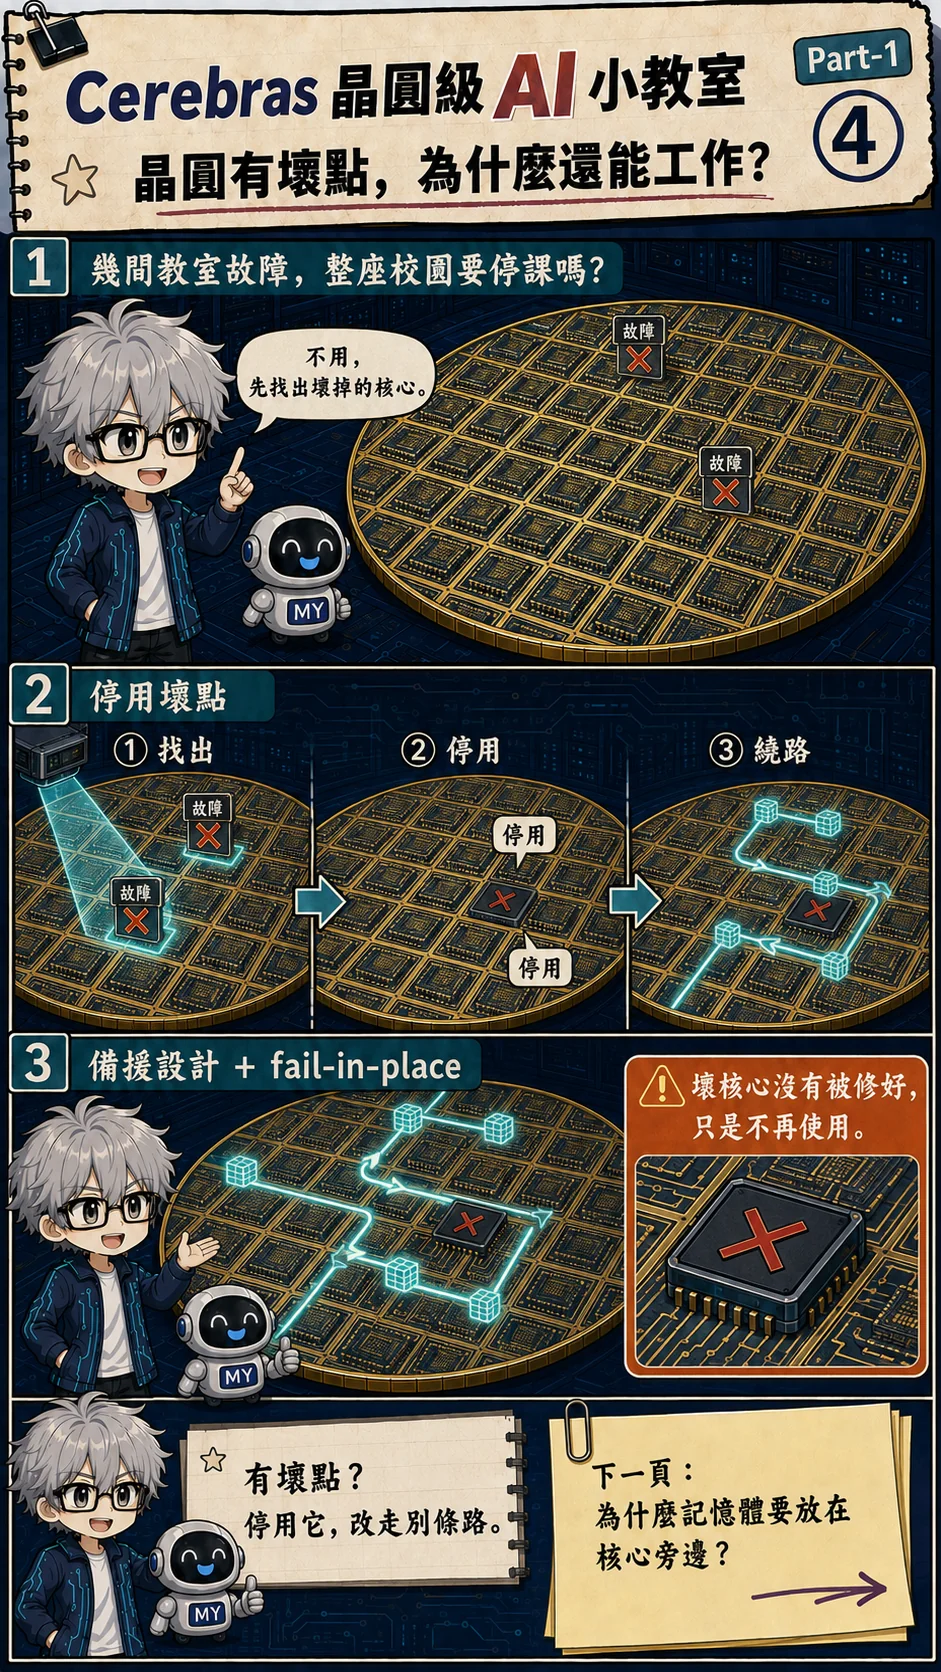
晶圓面積越大,越難期待每個角落都完美。若一個壞點就讓整片報廢,晶圓級處理器很難成為可交付的產品,所以架構一開始就得接受「有些教室可能關閉」。
而且不能只數壞點個數。十個分散的缺陷,也許能各自繞開;十個擠在關鍵通道附近的缺陷,可能切斷一大片區域。良率看的不只是 defect count,還包含缺陷分布、剩餘連通性與可用效能。
實際流程可以記成四步:先測試,找出壞掉的核心或道路;再停用故障區;接著啟用預留資源;最後重新安排路線。Cerebras 公開描述了冗餘核心、冗餘路由與 fail-in-place。[1]
這不是把壞電晶體修好,而是建立一張「可用資源地圖」。編譯與系統設定依照這張地圖,避開不能用的 PE 與路徑,把工作放進仍然連通的區域。
備援核心會占面積,測試、分級與重新映射也有成本。工程目標不是追求零缺陷,而是在合理缺陷分布下,仍交付可預測、可驗證的容量與效能。
工程師延伸:良率靠架構,也靠測試
備援只有在製造測試能找出壞點、設定流程能建立一張仍然連通的 fabric 時才有用。備援比例、缺陷群聚、route reachability 與 performance binning,都是同一個 yield model 的一部分。
5. 為什麼記憶體要放在核心旁邊?
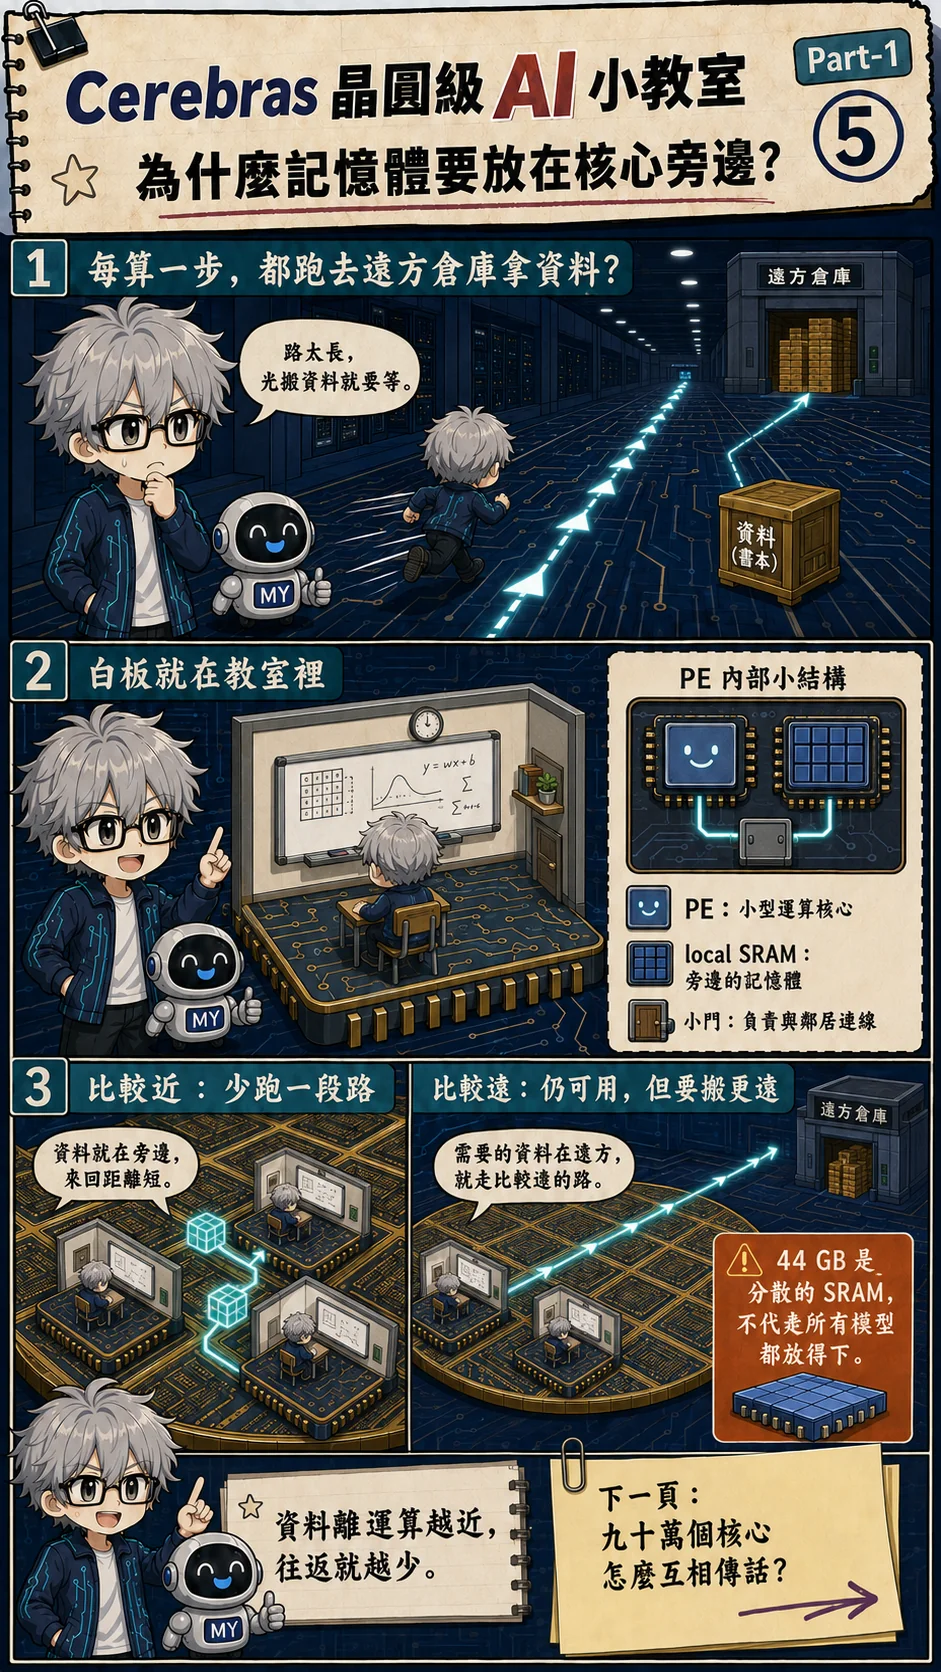
把 processing element(PE)想成一張學生書桌:有負責計算的學生、有隨手可寫的白板,還有通往東西南北的小門。真實 PE 也把運算引擎、local memory 與 router 放在一起,再透過二維網格和鄰居交換資料。[3]
SRAM 像桌邊白板,速度快、距離近,但每單位面積能放的資料較少。HBM 或一般 DRAM 更像較大的書庫,容量通常更容易做大,資料卻要經過更長的介面與路徑才能送到運算單元。
把常用資料留在 local SRAM,能減少反覆往返;代價是每個 PE 只能直接存取自己的資料與程式,其他 PE 不能把它當成一張透明共享白板。官方 SDK 也把 local memory、router 與顯式通訊列為 WSE 程式模型的一部分。[3]
WSE-3T 的 44 GB,是分散在整片晶圓上的 SRAM 總量,不是單一、無限大的記憶體池。編譯器必須安排資料放在哪個 PE、是否複製、何時傳給鄰居,以及哪段時間可以覆寫。
若 placement 做得不好,資料可能繞遠路、塞在少數通道,或因某些 PE 放不下而留下閒置計算。靠近核心只是硬體提供的機會,真正能不能得到 locality,還要看軟體如何使用它。
工程師延伸:分散式 SRAM 會改變程式模型
PE local memory 不是硬體一致的全域共享位址空間。資料 placement、replication、streaming 與 explicit communication,會決定是否真的得到 locality。容量數字要和各階段 working set、映射效率一起看。
6. 九十萬個核心怎麼互相傳資料?
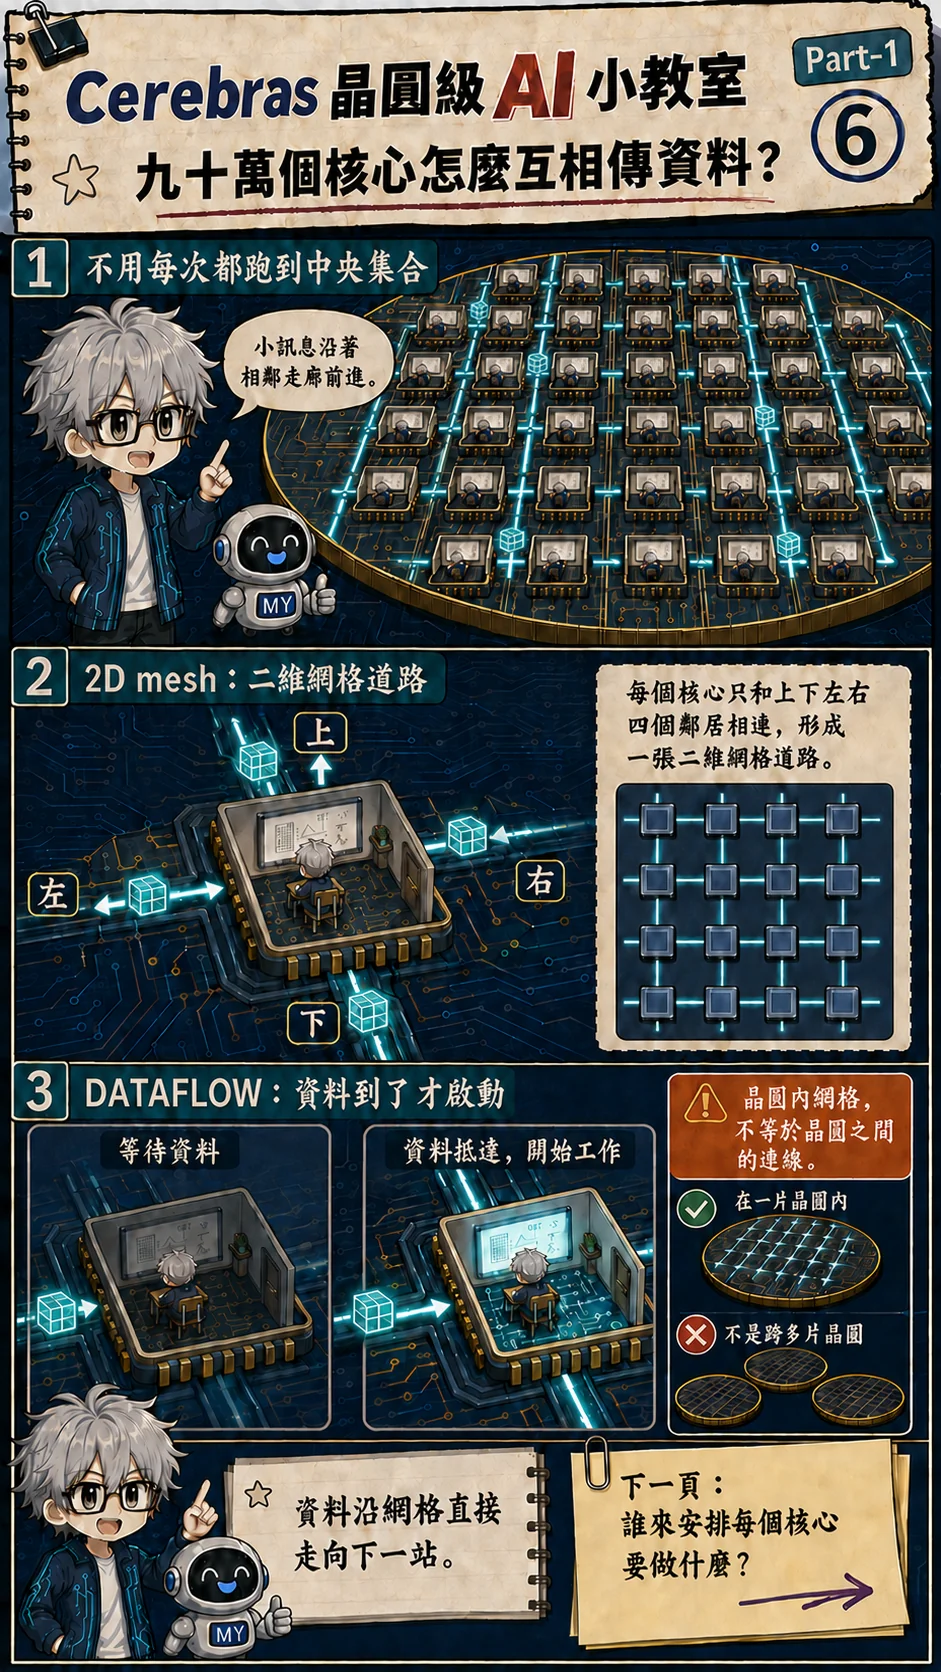
如果全校學生都得先去中央辦公室交換每張紙,辦公室很快就會塞爆。WSE 讓每個 PE 的 router 連到東、西、南、北鄰居,資料可以沿二維網格逐站前進。[3]
每多經過一個 router,就多一個 hop。近鄰交換通常走得短;若來源和目的地很遠,訊息就要經過更多 hop。路由規則決定它怎麼走,placement 則會影響一開始到底要走多遠。
多股流量搶同一段路時會產生 contention。下游來不及接收,壓力便可能往回傳,形成 backpressure。二維網格沒有消滅塞車,只是提供許多分散路徑,讓軟體有機會避開單一中央瓶頸。
官方 SDK 把 32-bit 小訊息稱為 wavelet。資料抵達 PE 後,可以觸發已準備好的 task;這是 dataflow 的直覺:工作何時能跑,取決於資料與相依條件是否到齊。[3]
要分清楚兩層概念:dataflow 是「工作何時啟動、相依如何推進」;2D mesh 是「資料走哪條實體道路」。而 CS-4 的晶圓間連線又是另一層校際高速公路,服務更長距離的流量。
工程師延伸:dataflow 仍需要流量控制
細粒度 wavelet 與 virtual channel 能減少中央排程,但 router 仍要處理 contention、buffer、dependency 與 backpressure。WSE-2 的 color 數量和 WSE-3 的 input queue 細節具有代際差異,不能混用。
7. 誰把模型分配到九十萬個核心?
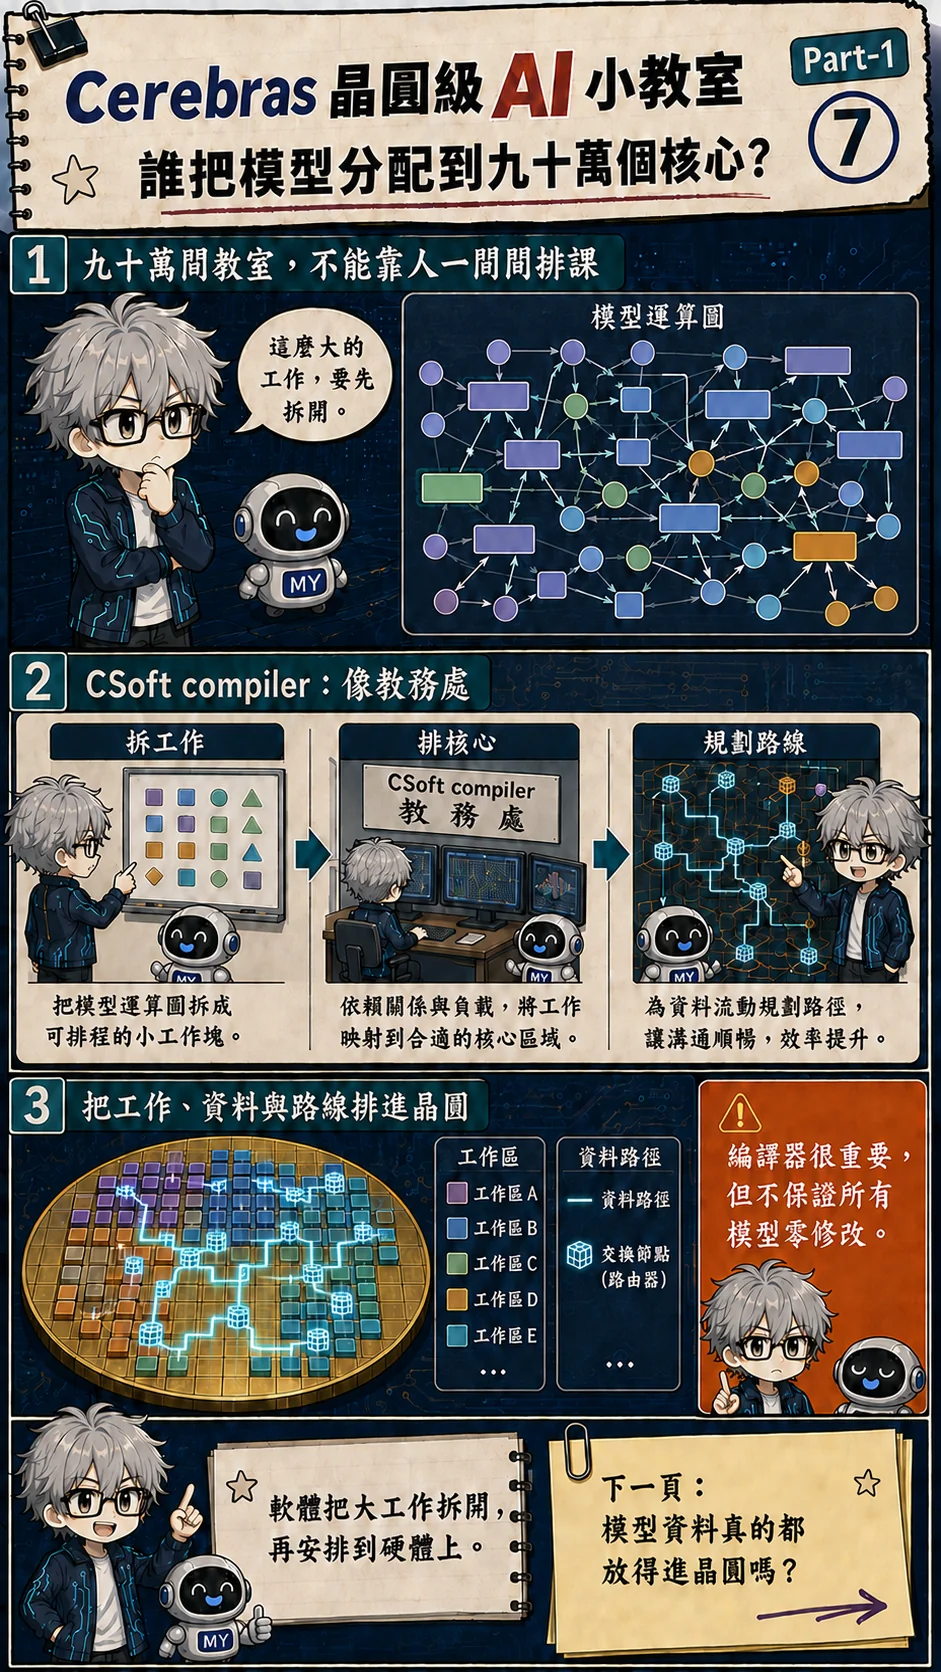
九十萬個核心像九十萬名學生,不可能由工程師逐一口頭分配工作。CSoft 比較像教務處:讀懂整份課程表,再決定誰負責哪一題、資料放在哪間教室,以及紙張要走哪條路。
先看一個三步驟的小圖:輸入乘上權重,結果通過 activation function,最後再交給下一層。這張圖不只列出三個運算,也記錄「第二步必須等第一步完成」的相依關係。
編譯器先做 partition,把大圖切成能分配的工作;再做 placement,把運算與資料放到實際 PE;接著安排 routing,指定 wavelet 的路徑;最後做 scheduling,決定哪些 task 何時可以啟動。Cerebras 的訓練文件也描述了從程式抽取 operation graph、配對 kernel 並映射到 WSE 的流程。[4]
好的 mapping 會把互相頻繁交換資料的工作放近一點,平衡 local memory 與道路負載,並避開測試後停用的區域。差的 mapping 可能讓某些 PE 忙到排隊,另一些 PE 卻在等資料,最後理論算力很高、實際利用率卻不理想。
這就是 hardware–software co-design:硬體提供核心、記憶體與道路,軟體決定如何使用。不過「有編譯器」不代表所有框架、算子、張量形狀與版本都能原封不動地得到最佳結果,部署前仍要驗證相容性與效能。
8. 模型一定整個住在晶圓裡嗎?
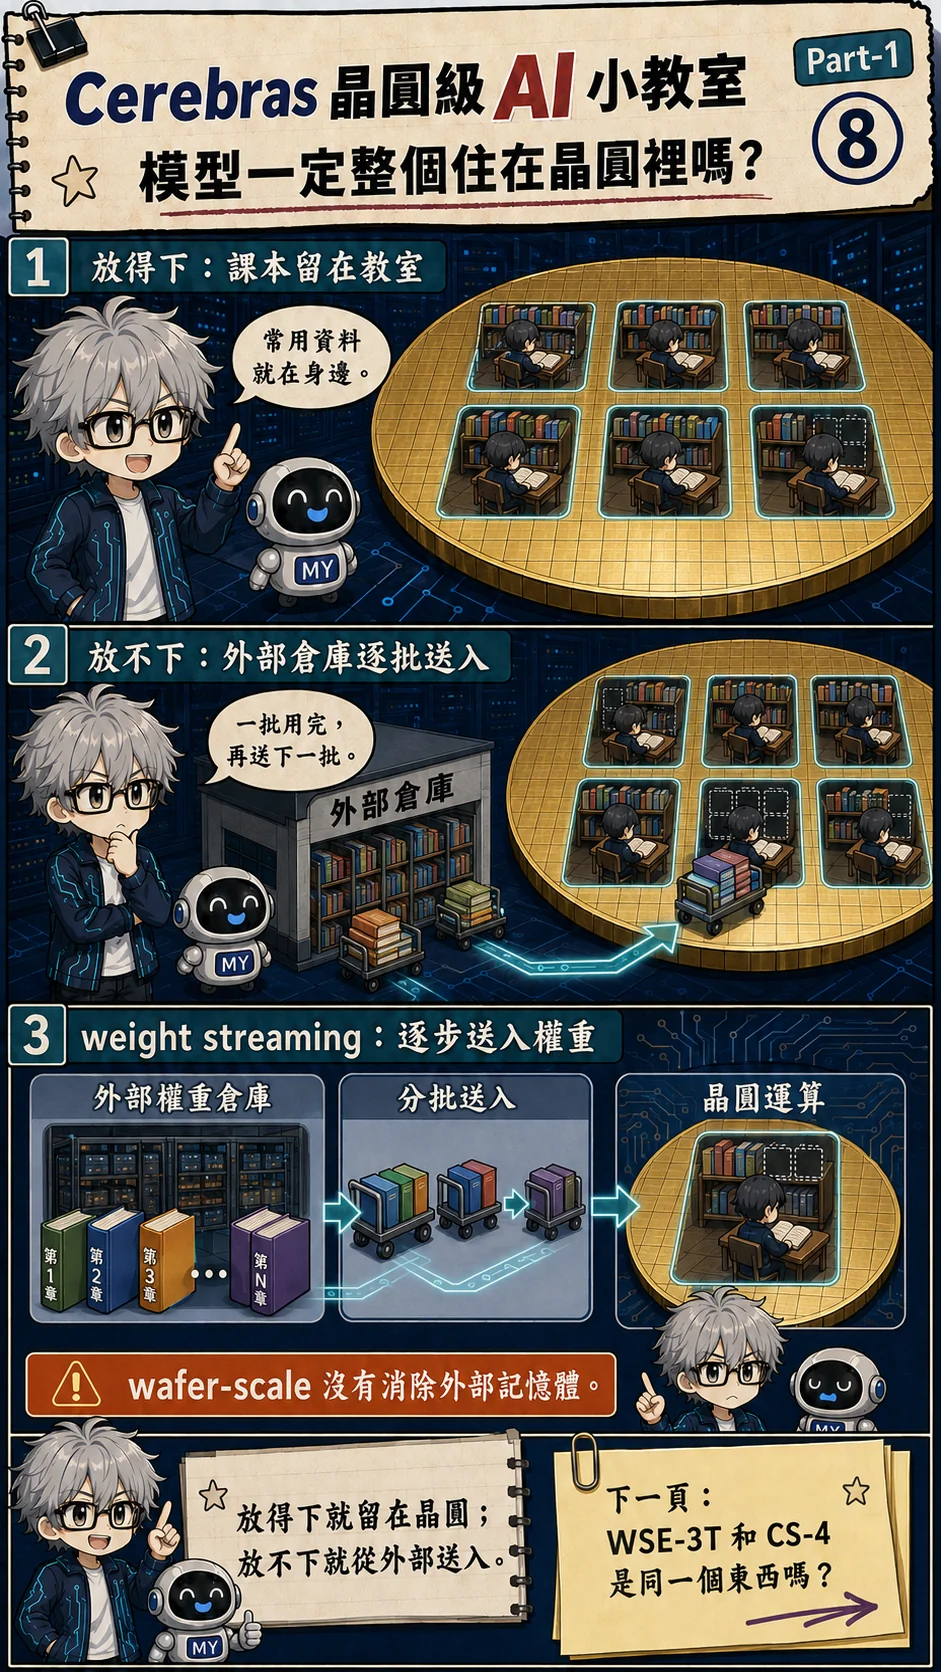
「模型放得下嗎?」不能只算權重。推論時還有中間 activation 與會隨 context、batch 成長的 KV cache;訓練時更要處理梯度與 optimizer state。不同階段的記憶體帳本差很多。
權重是模型學到的參數;activation 是資料通過每一層時產生的中間結果;梯度告訴訓練如何調整權重;optimizer state 則保存更新權重所需的額外歷史。KV cache 是生成式推論為既有 token 留下的注意力筆記。它們用途不同,不能全部叫成「模型大小」。
若工作集能放進片上 SRAM,更多資料就能留在運算附近;放不下時,系統必須分批載入、串流或切分。這不是失敗,而是記憶體階層原本就要做的工作,關鍵在搬移能否與計算配合。
在較早期的 Cerebras scale-out 訓練架構裡,MemoryX 像外部權重倉庫:模型一層一層載入 WSE,activation 留在 WSE,算出的梯度再送回。[4]
需要多套系統時,SwarmX 會廣播權重並彙整梯度,讓模型容量和計算容量不必綁死在相同比例。[6]
產品代際仍要分清楚。MemoryX/SwarmX 是既有 CS-2 scale-out 敘事;CS-4 則介紹 Nexus、Direct Wafer Links 與分離式推論。[5] 它們都處理資料搬移,卻不是同一個零件,也不能只憑名稱判定完全取代關係。
工程師延伸:模型「放得下」必須先說是哪個階段
權重只是容量的一部分。訓練還有 optimizer state、gradient 與 activation;推論還有會隨 batch 和 context 成長的 KV cache。談 residency 時,必須一起標明階段、精度、parallelism 與其他 runtime state。
9. WSE-3T 和 CS-4 是同一個東西嗎?
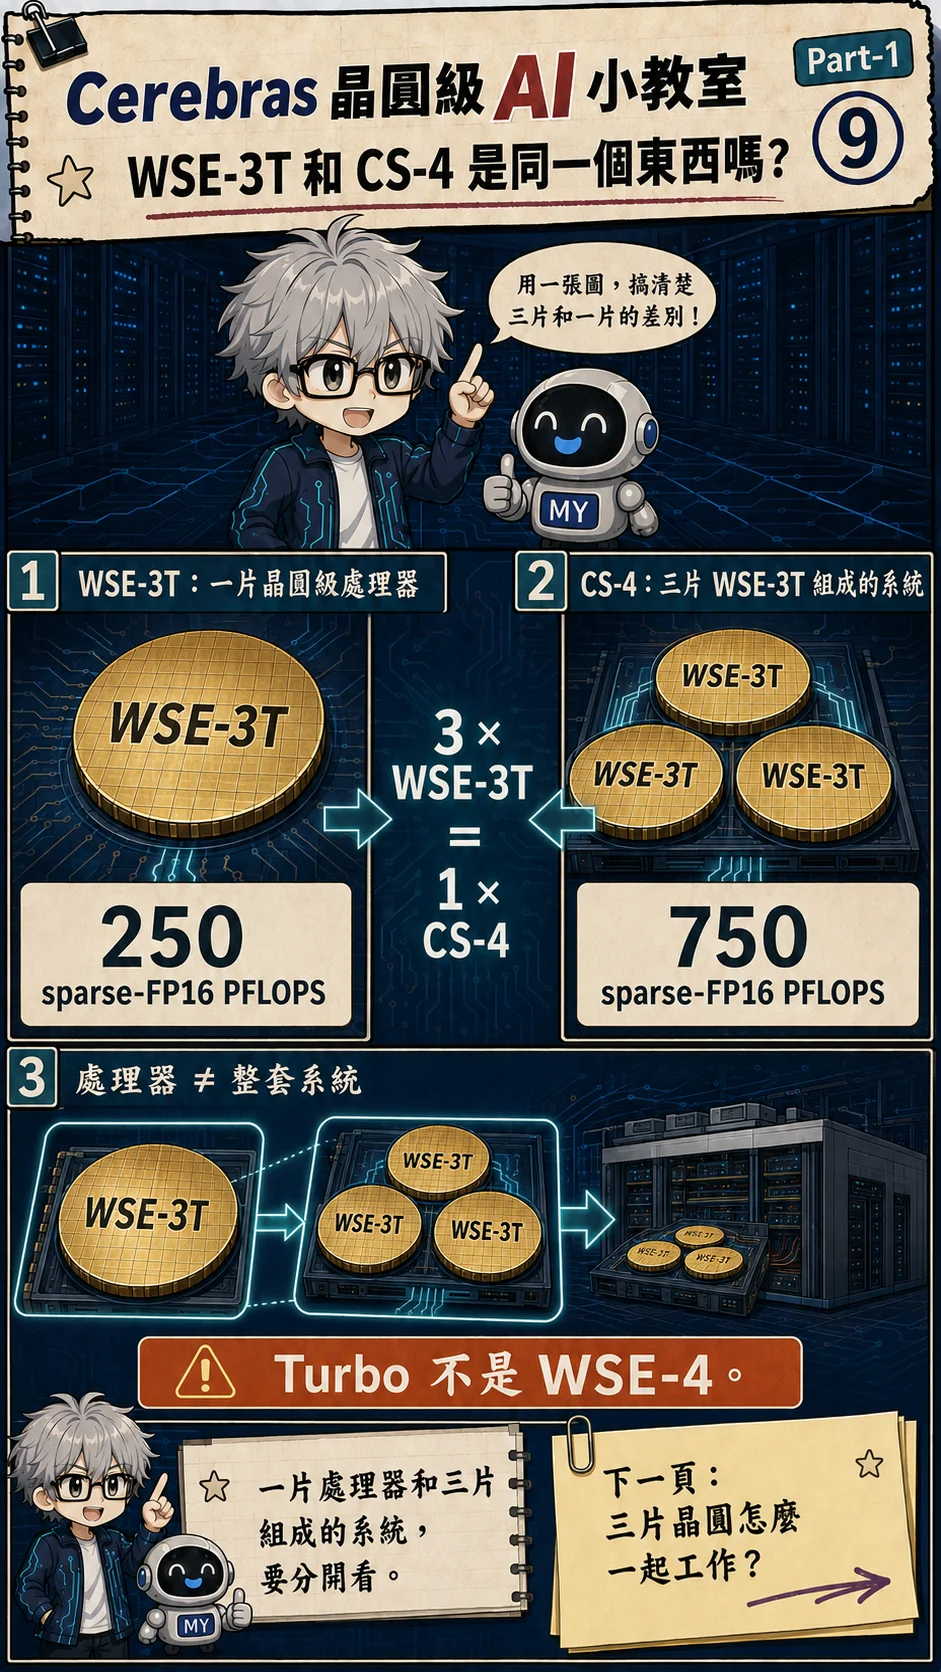
先把數量關係釘牢:WSE-3T 是一片晶圓級處理器,CS-4 是裝有三片 WSE-3T 的完整系統。就像一具引擎與裝了三具引擎的車不是同一層產品,單片數字不能直接拿來代表整機。
FLOP 是一次浮點運算;PFLOPS 的 P 代表 peta,也就是每秒 10 的 15 次方個 FLOP。它像引擎的理論馬力,方便看運算上限,卻不等於完成一趟真實旅程所需的時間。
FP16 表示使用 16-bit 浮點格式;sparse 則表示計算利用了資料中的零值或稀疏結構。精度、稀疏比例與哪些運算能被跳過,都是規格的一部分,不能只留下最大的數字。
官方列出的單片 WSE-3T 為 250 sparse-FP16 PFLOPS 與 43.2 PB/s 記憶體頻寬;三片組成的 CS-4 合計為 750 sparse-FP16 PFLOPS。[2] 250 和 750 的差別首先是單片與三片,不是兩種神祕演算法。
實際模型速度還受利用率、通訊、資料形狀、軟體與輸出條件影響。Turbo 是加速版 WSE-3 的名稱,不是 WSE-4;官方把提升連結到 CS-4 的供電與系統設計,未公開的時脈、TDP、製程或微架構細節不應自行補上。
工程師延伸:PFLOPS 不是應用程式 benchmark
Sparse-FP16 peak compute 綁定數值格式與稀疏條件。端到端吞吐還受 utilization、通訊、記憶體、序列形狀、編譯器、host overhead 與品質限制影響。應比較相同工作負載,而不是單一 headline number。
10. 三片晶圓怎麼一起工作?
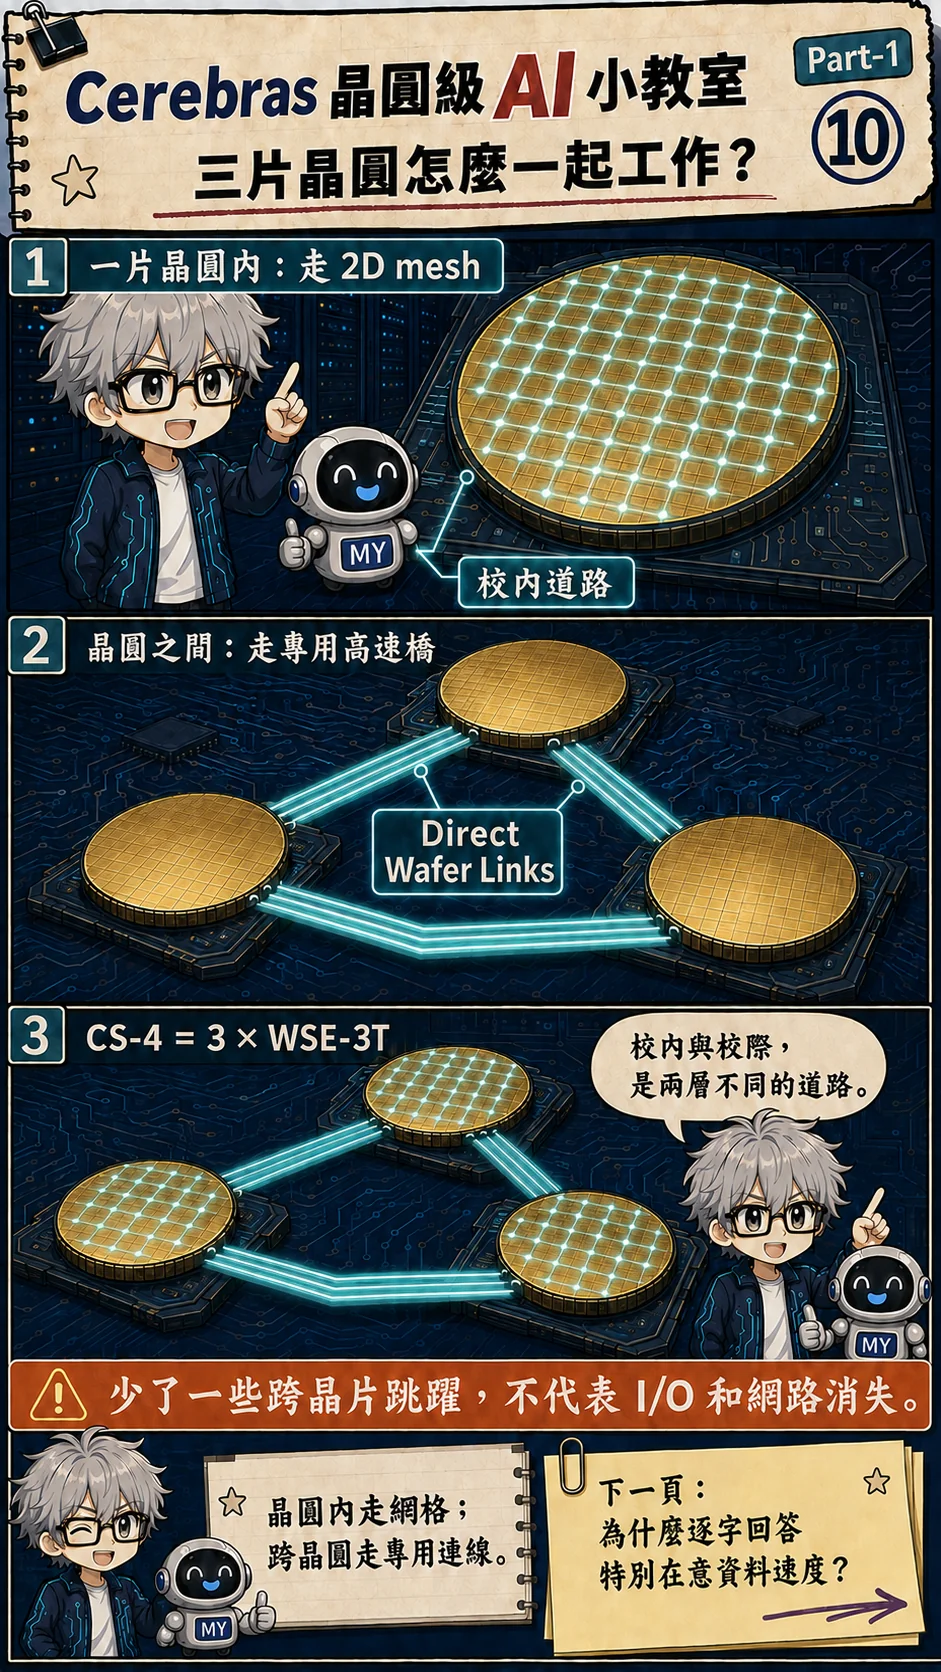
一片 WSE 內的 2D mesh 像校內道路,連接一間間 PE 教室。工作跨到另一片 WSE-3T 時,就要上校際高速公路:CS-4 使用 wafer I/O 與 Direct Wafer Links,在晶圓之間交換資料。
多晶圓運算的第一步是 partition:把模型、batch 或推論階段分給不同晶圓。最直觀的資料平行,是每片處理不同樣本;模型平行則把同一模型的不同部分分開;pipeline 的直覺,是上一站完成一段後交給下一站。
切分之後一定會有交界。資料要跨晶圓傳遞,某些步驟要同步;若一片花 8 秒、另一片花 12 秒,較快的一片仍可能等最慢者。這就是 load imbalance,它會吃掉一部分理論加速。
Cerebras 表示,在其系統條件下,wafer-to-wafer latency 最低可到 2 微秒。[5] 這能說明專用鏈路很快,卻不是任何距離、配置與工作負載都保證得到的固定數字。
Nexus 把 Compute、Power 與 I/O 做成模組,方便部署、維護與擴充。[2] 但模組化不會讓物理距離消失;系統仍要處理同步、流量、故障隔離與重試。
所以多晶圓不是把單片效能乘三就結束。鏈路、切分方式、最慢階段與失效時的影響範圍,會共同決定整套系統能交付多少有效工作。
工程師延伸:兩層網路有兩種 traffic model
PE mesh 處理晶圓內的細粒度資料,Direct Wafer Links 則承擔 WSE-3T 之間被切分的工作。即使 link latency 很低,partition boundary、collective、同步與 failure handling 仍是系統級設計問題。
11. 為什麼逐字回答特別在意資料速度?
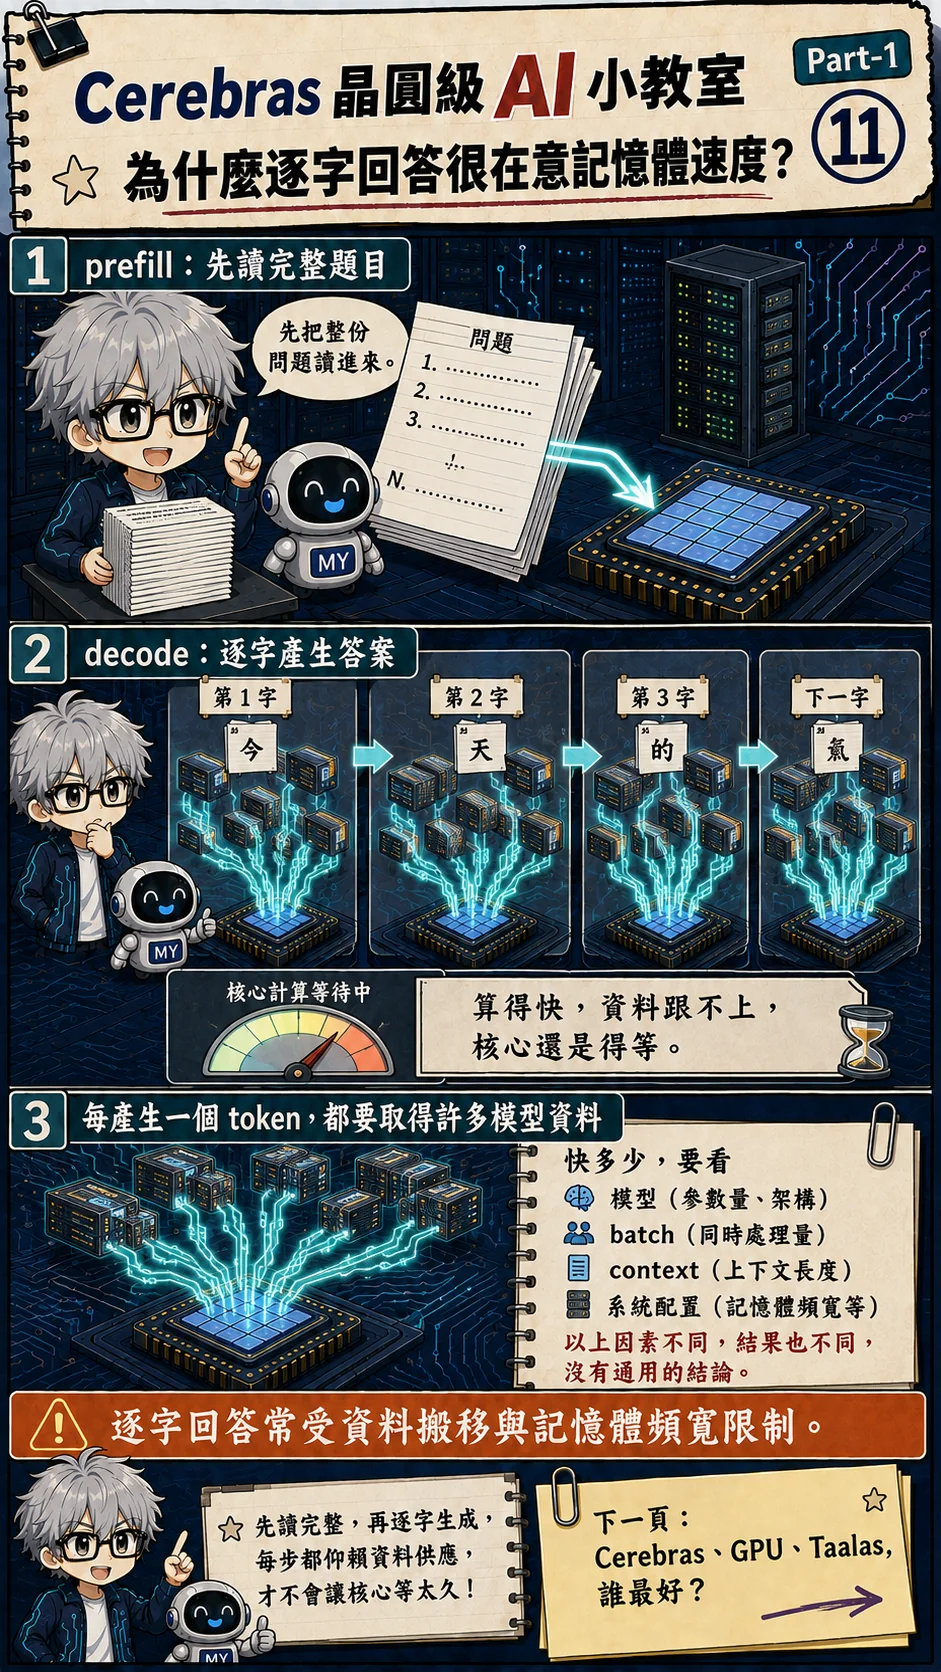
假設你問:「為什麼天空是藍色?」模型先讀完整句子,建立對每個 token 的上下文理解,這一段叫 prefill。接著它先產生「因為」,再用原問題和「因為」決定下一個 token;這個逐步生成的階段叫 decode。
Prefill 一次有整段 prompt,通常有較多可以平行處理的矩陣運算。它最直接影響 time to first token:從你送出問題,到螢幕出現第一個字要等多久。
Decode 每一步新增一個 token,卻要反覆使用模型權重與先前留下的 KV cache。對話越長、同時服務的序列越多,KV cache 通常也越大;若資料沒及時送到,運算單元就得等待。
因此「速度」至少有三種問法:第一個 token 多快出現、之後每秒能產生多少 token、整個系統同時能服務多少請求。低 batch 追求互動感,大 batch 追求總吞吐,最佳配置不一定相同。
Batch、prompt 長度、output 長度、模型、精度、稀疏性與軟體版本都會改變結果。把某個 tokens/s 數字搬到另一種條件下,常會得到錯誤結論。
Cerebras 官網也明示,其 GPU 比較會隨工作負載、配置、日期與模型而異。[1] 真正公平的比較,必須把延遲、吞吐與測試條件一起寫出來。
工程師延伸:prefill 與 decode 壓力不同
Prefill 常有較多可平行的矩陣運算;低 batch decode 則可能被反覆的權重與 KV traffic 限制。把兩個階段分離可以各自配置資源,但也會增加 handoff、queueing 與 load balancing 問題。延遲數字至少要交代 prompt、output、batch、model、precision 與 percentile。
12. Cerebras、GPU 與 Taalas,誰最好?
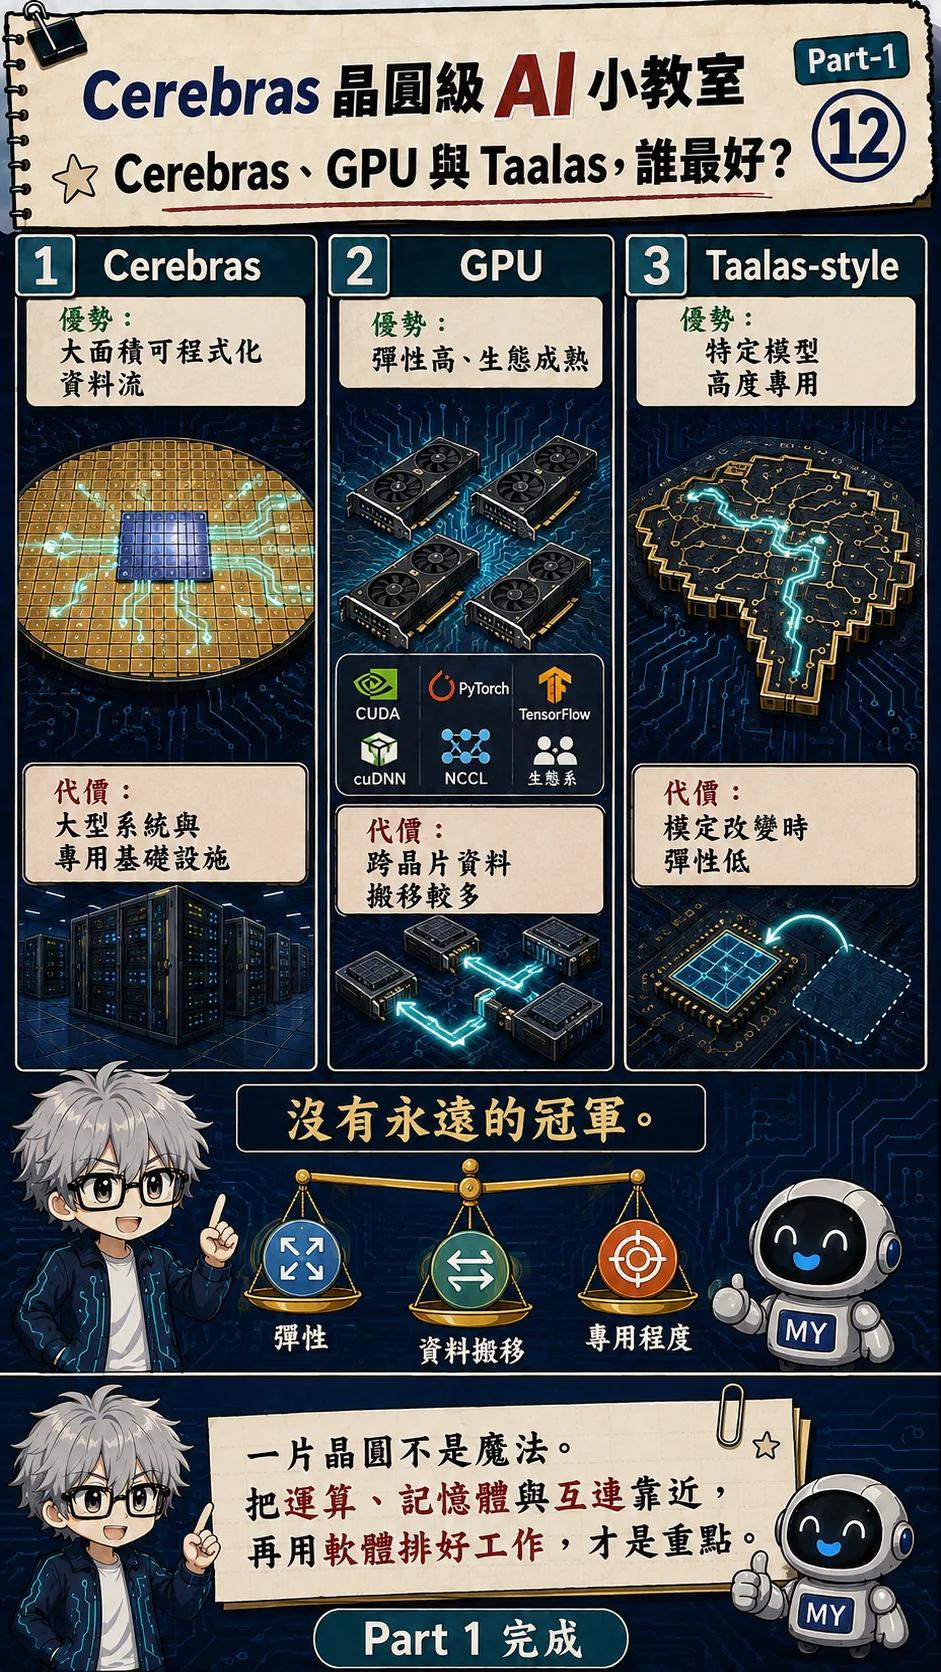
最後把三種架構想成三座校園。Cerebras 是大型一體化校園:運算、local memory 與晶圓內道路靠得很近,成本落在專用系統、供電散熱與工具鏈。GPU 叢集像由標準校舍組成的大學城:軟體生態與彈性較成熟,但資料會經過 HBM、封裝與跨加速器網路。
Taalas-style 更像為固定課程量身打造的專門學校,把模型權重與資料路徑直接做進晶片,可能進一步降低權重搬移;代價是模型一改,硬體設計和流片也可能重來。它與可程式化的晶圓級資料流,是不同方向。
情境一:研究團隊每週換模型、改算子、試新精度。這時軟體支援、除錯能力與重編程彈性通常比極致專用化更重要,GPU 生態常有明顯優勢,Cerebras 則要看目標模型是否在其支援路徑內。
情境二:要訓練巨大模型,真正問題可能是模型狀態放哪裡、跨節點怎麼同步、整體利用率能否維持。此時 Cerebras 的 weight streaming 或多晶圓設計值得評估,但仍要以實際模型與軟體版本測試。
情境三:同一個固定模型要大量、長期推論,而且模型更新很少。硬連線方案可能願意犧牲彈性,換取更少的權重搬移與更高專用效率;前提是量產規模足以承擔 NRE 與產品變更風險。
可重複使用的決策清單是:模型多久改一次?哪些資料必須常駐?batch、首字延遲與總吞吐目標是什麼?軟體是否支援?供電、冷卻、網路、維護與 NRE 誰承擔?沒有脫離工作負載的永久冠軍,只有成本放得是否合理。
工程師延伸:比較邊界必須涵蓋整個產品
公平比較要納入 compiler coverage、模型更新週期、供電、冷卻、網路、可用性、fault containment、observability、採購與 NRE。較窄的矽晶片指標仍然有用,但不能獨自決定系統勝負。
下方互動用 4×4 網格讓你選停用格子,逐 hop 檢查封包能不能抵達。切斷一整欄時,兩側可能不再連通:繞路有條件,壞點沒有被修復。這是自訂 BFS 與 store-and-forward 模型,不是 WSE 路由、時脈或良率模擬。
五句話複習
- AI 效能不只看算術,也常卡在資料搬移。
- WSE 用 reticle stitching 把多個曝光區連成一片晶圓級處理器。
- 冗餘核心與路由讓系統避開壞點,不是把壞點修復。
- WSE-3T 是單片處理器;CS-4 是三片 WSE-3T 的系統。
- Cerebras、GPU 與硬連線推論各有適用場景,沒有脫離工作負載的永久勝負。
下一站
下一篇可以繼續追兩條線:一條深入 WSE 上的 CSL/dataflow 編程;另一條比較晶圓級 scale-up、GPU scale-out 與模型專用 ASIC。先別急著背規格,試著用「資料放哪裡、怎麼走、誰來排」重新看每一張架構圖。
Hashtags
#Cerebras #WaferScaleEngine #WSE3T #CS4 #WaferScaleAI #Dataflow #AIAccelerator #Semiconductor #漫畫小教室
References
- Cerebras, WSE-3T product page — WSE-3T 尺寸、電晶體、核心、SRAM 與缺陷容忍;效能倍數屬廠商比較。
- Cerebras, CS-4 product page — 三片 WSE-3T、Nexus、單片與整機規格,以及比較限制。
- Cerebras SDK, Wafer-Scale Engine Architecture — PE、local memory、2D mesh、wavelet 與程式模型。
- Cerebras Training Docs, Weight Streaming Execution — MemoryX 與 weight streaming 的訓練架構背景。
- Cerebras, Introducing CS-4 — Nexus、Direct Wafer Links 與分離式推論的當代產品說明。
- Cerebras, Extreme-Scale AI Architecture — CS-2、MemoryX、SwarmX 與 weight streaming 的原始官方說明。
- Gary Lauterbach, “The Path to Successful Wafer-Scale Integration: The Cerebras Story,” IEEE Micro (2021) — 525 mm² 標準曝光區、偏移連線光罩、上層金屬 field stitching 與晶圓級良率設計。
- Cerebras, Architecture Deep Dive — 不到 1 mm 的劃片槽、高層金屬、平行介面、百萬條跨界線與自動校正。
- Cerebras, Wafer-Scale AI, Hot Chips 2024 — WSE-3 的 84 個 die 區、跨 reticle fabric、台積電 5 nm 合作與內建備援。
互動練習:壞點還在,資料改走哪裡?
選來源、目的地與停用格子,讓 BFS 找出可用最短路。逐 hop 看封包前進,再試著切斷整欄;冗餘路徑能繞路,不能保證任何故障都可跨過。
4×4 PE 網格與 store-and-forward 封包是自訂教學模型,不是 WSE 路由、reticle 地圖、CSL 模擬或時脈效能。每條邊搬一個 wavelet 花一個假想 tick,整個封包收齊才走下一 hop;忽略並行流量、buffer、virtual channel 與 backpressure。數字不能換成 Cerebras 延遲。
學習指南
AI 技術小教室
先備知識
- 只需晶片、記憶體與 AI 推論的基本概念,不要求半導體背景
我學會了什麼
- 說明資料搬移為何可能限制 AI 運算
- 說明 reticle stitching 與備援如何讓晶圓級處理器可行
- 區分 WSE-3T 處理器與三晶圓 CS-4 系統規格
- 在不預設贏家的前提下比較 Cerebras、GPU 叢集與硬連線推論