先看副本,再看四個字母
Cache 把常用資料搬到核心旁邊,速度因此變快;但多核心各有私有 Cache,也讓同一個位址同時出現好幾份副本。副本一旦不同步,兩顆 Core 就可能看到不同世界。
十二張圖會沿著同一條故事線前進:Memory Wall 催生 Cache,Locality 讓它有效,MESI 替副本標身分,Snoop 與 Directory 協調 owner,NoC 搬送訊息,CXL 再把問題帶到晶片外。
第一遍先看便利商店、狀態貼紙與戶籍名冊的比喻;第二遍再打開 Atomic、False Sharing、Coherence 與 Consistency 的工程師延伸。
假設你把一項資料處理工作交給更多核心。每個核心都能在近處保存常用資料,工作卻沒有等比例變快。有時它們在等主記憶體,有時在等另一顆核心交出寫入權。要判斷該加大 Cache、調整資料排列,還是減少共享寫入,得先分清楚這些等待從哪裡來。這是教學情境,不是某款處理器的實測。
本課沿著原有十二張圖,先看資料為什麼要放近,再追蹤同一份資料的副本如何交接。正文會把便利商店、狀態貼紙與名冊接回真實機制。進階的替換策略、原子操作與協定細節放在摺疊段落;第一次讀,可以先沿主線理解誰在等待、等待什麼。
1. Memory Wall:CPU 很快,資料卻送不過來
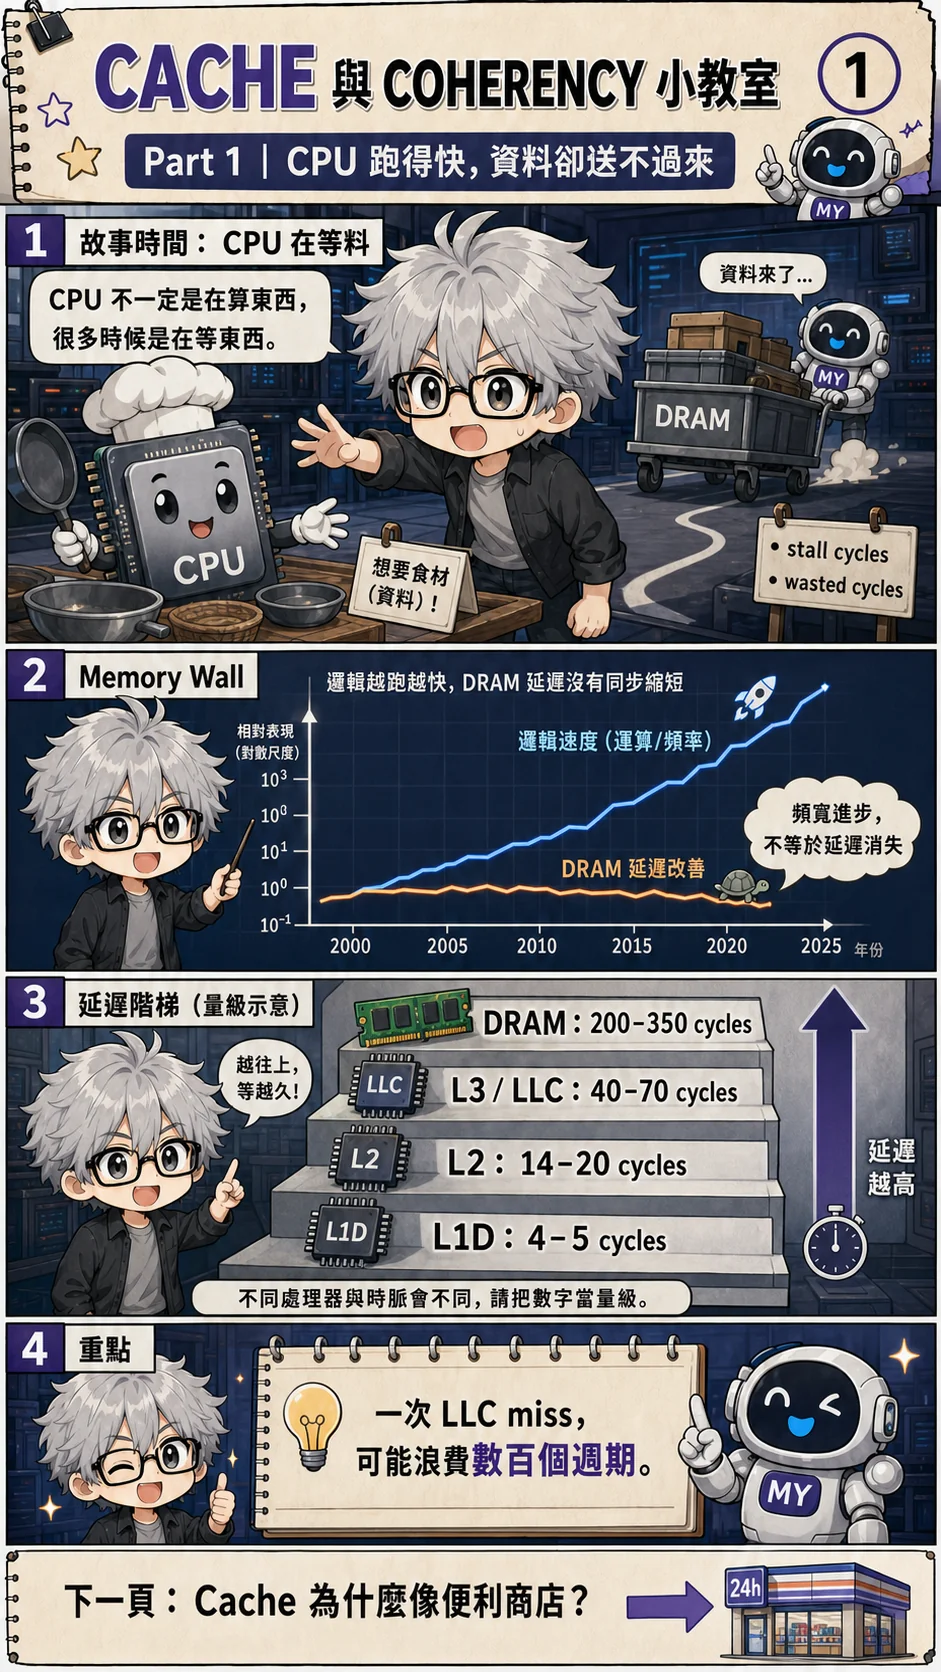
回到一個資料處理工作。核心讀入資料、計算,再讀下一筆。若資料已在近處,計算能繼續;若必須從主記憶體取回,依賴那筆資料的指令就得等待。時脈仍然在走,但這段等待沒有完成原本要做的工作。提高時脈,未必能讓資料更早送到。
這種運算與資料供應之間的落差,稱為 Memory Wall。理解它要分開兩件事。延遲是等第一筆資料需要多久;頻寬是持續傳送時,每秒能搬多少資料。道路加寬能讓更多車通行,單輛車走完路程仍需要時間。這是比喻,真實延遲還包含控制器排隊與記憶體操作。[1]
圖中的 L1D、L2、LLC 與 DRAM 階梯,表示存取成本可能跨越很大的量級。標出的 cycles 是示意範圍,會隨處理器、時脈與負載改變。不能把一次 LLC miss 固定換成「浪費幾條指令」。亂序執行的核心可能先做其他獨立工作;只有相依工作或資源限制使等待無法隱藏時,才會明顯拖長執行時間。[4]
診斷這項工作要看資料怎麼來。若每次都等同一類讀取,把算術單元做得更快,可能只是更快用完已到手的資料。Cache 提供另一種做法:把可能再用到的資料留在核心附近,減少反覆走遠路的次數。
2. Cache:不要每次都跑去大賣場
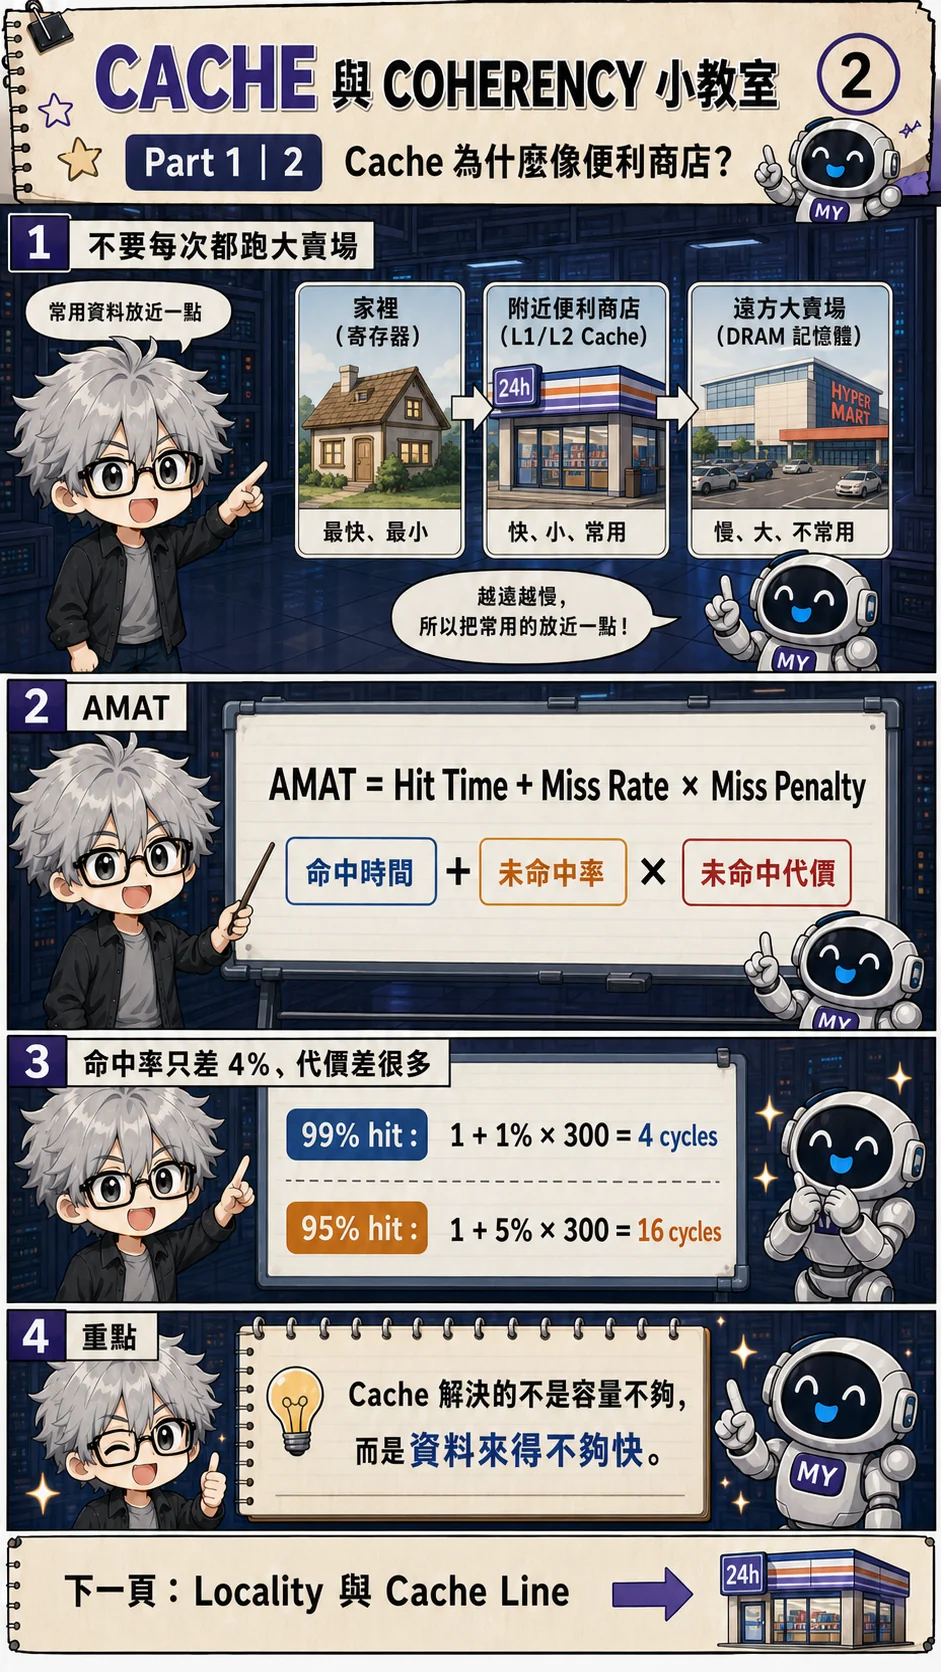
便利商店的比喻解釋了 Cache 的用途。住家附近的店放不下大賣場全部商品,卻能備好常買的東西。核心先找近處的副本。找到了叫命中(hit);找不到叫未命中(miss),請求才繼續往下一層。Cache 會占用晶片儲存空間,但不會因此增加程式可用的主記憶體容量。
平均記憶體存取時間稱為 AMAT。簡化單層模型寫成 AMAT = Hit Time + Miss Rate × Miss Penalty。Hit Time 是每次查詢付出的時間。Miss Rate 是查詢未命中的比例;Miss Penalty 是未命中後額外付出的時間。三項要使用相容的單位,才能相加。這個模型用來比較平均存取成本,不直接預測整支程式的執行時間。[1]
圖 2 假設命中花 1 cycle,未命中額外花 300 cycles。99% 命中時,平均是 1 + 0.01 × 300 = 4;95% 命中則是 1 + 0.05 × 300 = 16。命中率差四個百分點,這個模型的平均成本差四倍。若把代價改成 100,答案才會變成 2 與 6。兩組都是教學算例,不能當成某顆 CPU 的實測結果。
這也說明為什麼要檢查 miss 的來源。增加容量可能改善一部分未命中,卻可能讓查詢更慢。預取(prefetch)把資料提早搬來,有機會讓需求讀取命中。多筆獨立請求重疊則能隱藏部分等待,稱為 memory-level parallelism。它不表示單筆 DRAM 請求本身變快,也不能直接代入 AMAT 當成所有 miss penalty 都縮短。
3. Locality 與 Cache Line:CPU 為什麼敢一次搬一整批?
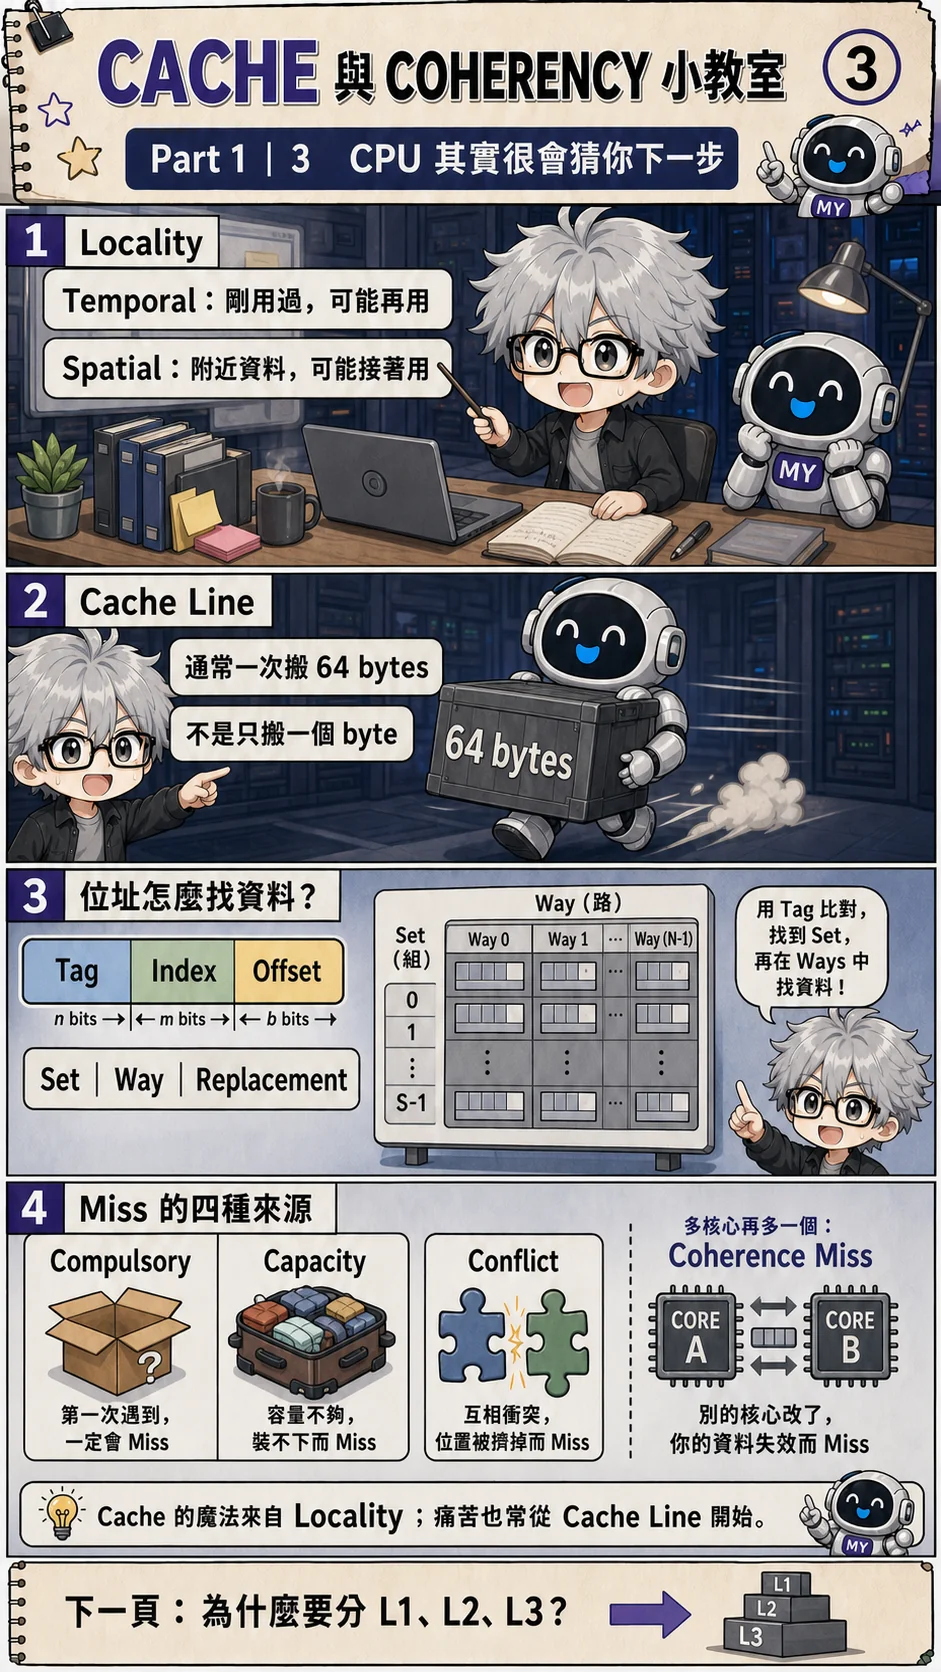
先看同一個工作如何讀資料。程式加總一排數字時,通常讀完這個位置就讀旁邊的位置;迴圈裡反覆使用同一個值,也可能很快再讀到它。前者是空間局部性(spatial locality),後者是時間局部性(temporal locality)。Cache 利用這些存取特性,讓少量近端儲存涵蓋經常使用的資料。[1]
硬體通常一次搬一條 cache line。圖中用常見的 64 bytes 示範,但大小要看實際處理器。讀其中一個數值時,附近資料也跟著進來。若稍後會使用它們,這趟搬運就值得;若每次只讀一小部分便跳到很遠的位置,大部分搬來的資料可能沒有被用到。這時同樣的算術工作,也會付出更多搬運成本。
Cache 還得知道副本放在哪裡。圖中的 Index 選出一個集合(set),Tag 用來辨認它屬於哪一段記憶體,Offset 選出 line 內的位置。同一個 set 可提供多個位置,稱為 ways。增加 ways 能減少某些位址彼此排擠的情況,但也需要更多比對與選取電路。
未命中的原因要分開看。第一次碰到資料是 compulsory miss;反覆需要的資料放不下,是 capacity miss;資料集中到同一個 set,互相排擠,是 conflict miss。多核心還可能因其他核心的寫入,使原本副本失效,產生 coherence miss。這四種情況需要不同改善方法;只加大 Cache,未必能解決共享寫入。
4. L1、L2、L3:為什麼 Cache 還要分層?
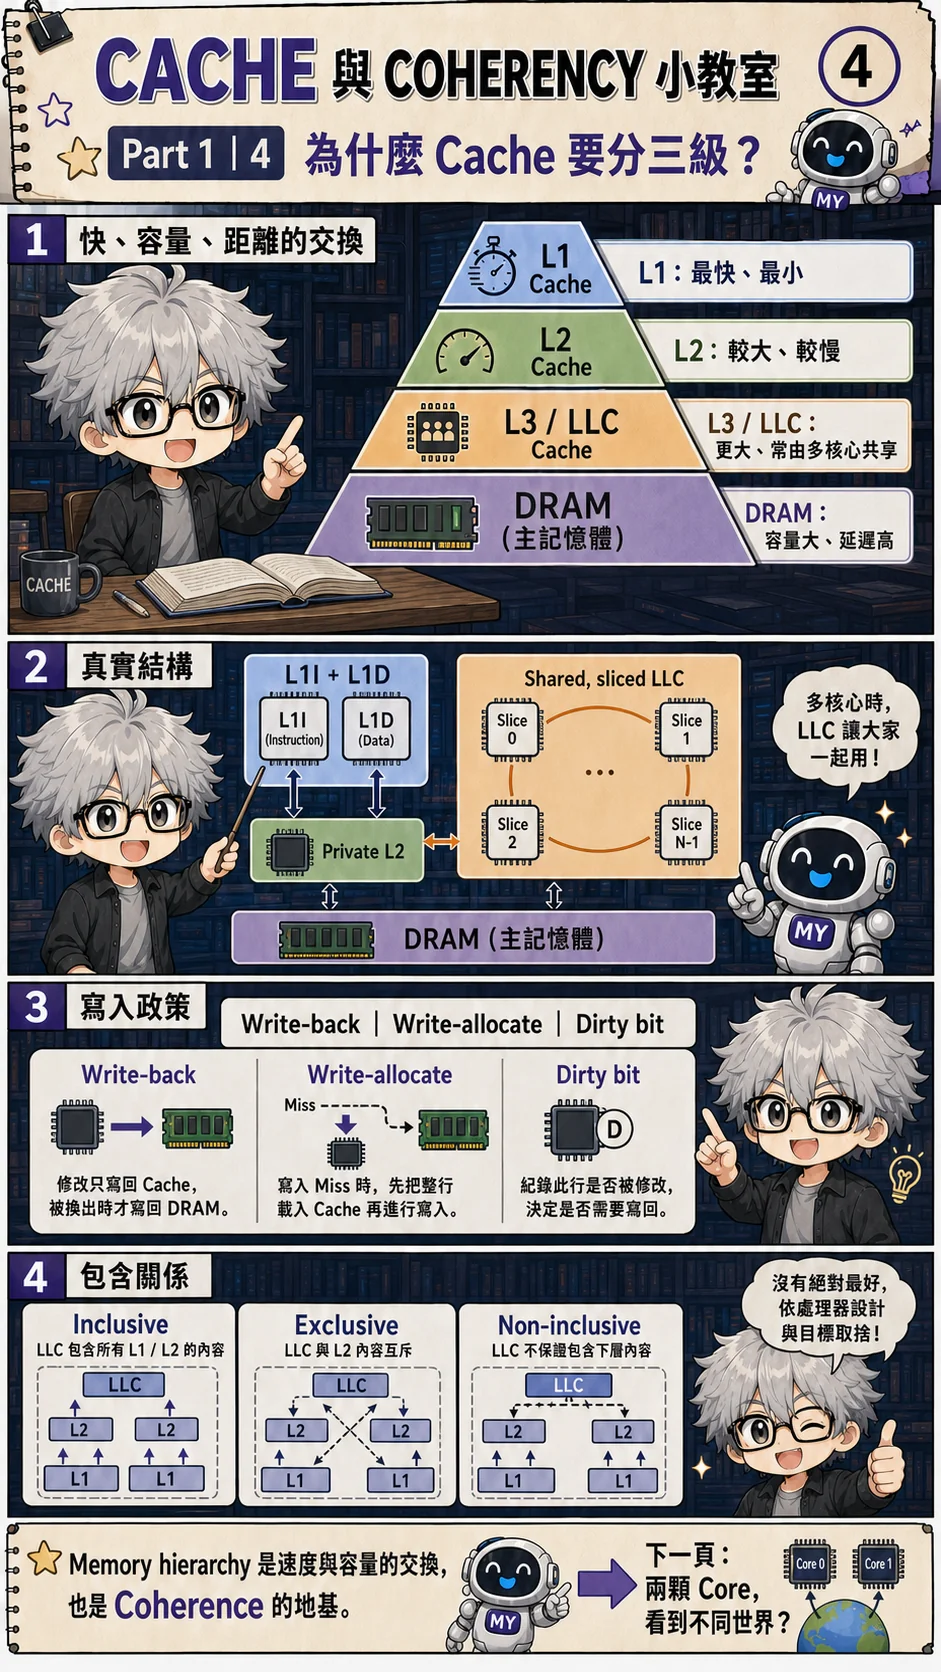
近端儲存愈大,就愈難維持極短的查詢時間。核心又希望大部分資料留在晶片內,因此常用多層 Cache。L1 優先服務最急的請求,容量較小;後續層用較大容量接住 L1 放不下的資料。先查近處,必要時再走遠一些,能兼顧常見存取與較大的工作資料量。
圖 4 示範常見組織。L1 可分為指令快取與資料快取,讓取指令和讀寫資料有各自的路徑。L2 常由單一核心使用,最後一層快取(LLC)則可能由多核心共享。共享 LLC 也可分成多個 slices。這是架構範例,不能據此假設每顆 CPU 都有相同層數或共享方式。[1]
寫入也有選擇。Write-through 會把寫入傳往下一層;write-back 可先更新快取副本,並記錄它已被修改。這個標記稱為 dirty bit,表示下一層可能還沒有最新內容。Write-allocate 則是在寫入未命中時,先取得對應的 line。若資料能留在近處反覆改寫,就可減少往下傳送的次數。
延後寫回帶來一個責任:最新資料可能只在某顆核心旁邊。副本被淘汰或別人要求讀取時,控制器必須依協定交出資料,不能直接丟掉。原本為了縮短等待而建立的層級,於是也成為下一個問題的來源。當不同核心都留有副本,誰負責維持正確內容?
工程師延伸:包含關係與替換策略
Inclusive、exclusive 與 non-inclusive/non-exclusive 描述不同層的資料包含關係。Inclusive LLC 可協助追蹤上層副本,但 LLC 淘汰 line 時,可能必須使上層副本失效。Non-inclusive 設計沒有同樣的包含保證,追蹤副本往往需要另外的 metadata。實際規則依產品設計而定。
Set-associative cache 還要選擇淘汰哪個 way。近似 LRU 嘗試保留最近用過的資料,RRIP 則估計資料多久後才可能再被使用。提高命中率仍要付出狀態、更新邏輯與驗證成本,不能只用容量比較兩個設計。
5. 多核心副本:兩顆 Core 為什麼看到不同世界?
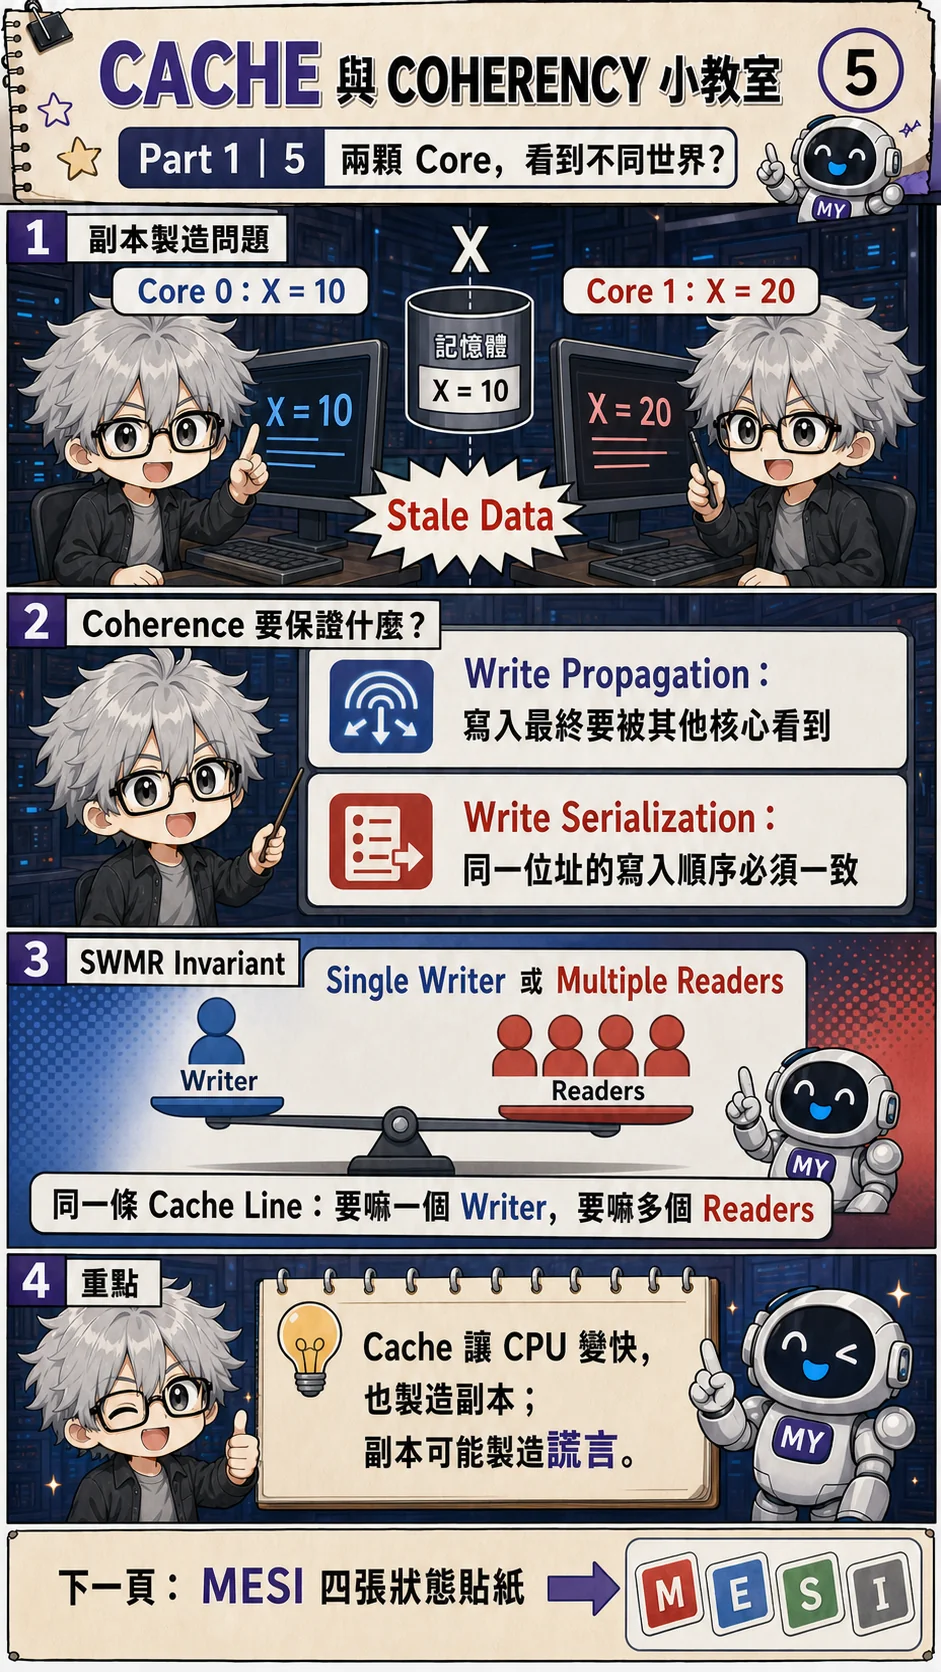
讓兩顆核心共同處理資料。它們先各自讀到 X = 10,並把副本留在 private cache。接著其中一顆要把 X 改成 20。如果沒有管理副本的規則,另一顆仍可能一直拿自己的舊值 10 做後續計算。這是教學情境,用來說明硬體為什麼需要 cache coherence。[2]
Coherence 要讓同一位址的寫入能被其他參與者取得,也要讓它們對該位址的寫入先後保持一致。這不要求所有 Cache 在每一瞬間都裝著同一個值。有些副本可以失效,直到下次使用才重新取得資料;重要的是不能把無效的舊副本當成有效資料繼續使用。
可以先記住一條權限規則。同一條 line 在協定允許的存取階段,要有單一可寫持有者,或有多個唯讀持有者。這稱為 SWMR。可寫持有者也能讀自己的資料;「單一寫入者」不是禁止它讀。其他核心要寫之前,必須取得權限,並處理原有副本。資料交接還要保留前一個寫入階段的內容。[2]
硬體管理的是 line 的權限與資料交接。程式如果要兩個執行緒共同更新計數,仍需要合法的同步或原子操作。Coherence 不會自動把「讀、加一、寫回」三個動作變成不可分割的一次更新。下一步先看硬體如何替每份副本記錄權限。
6. MESI 四種狀態:每份副本都有身分
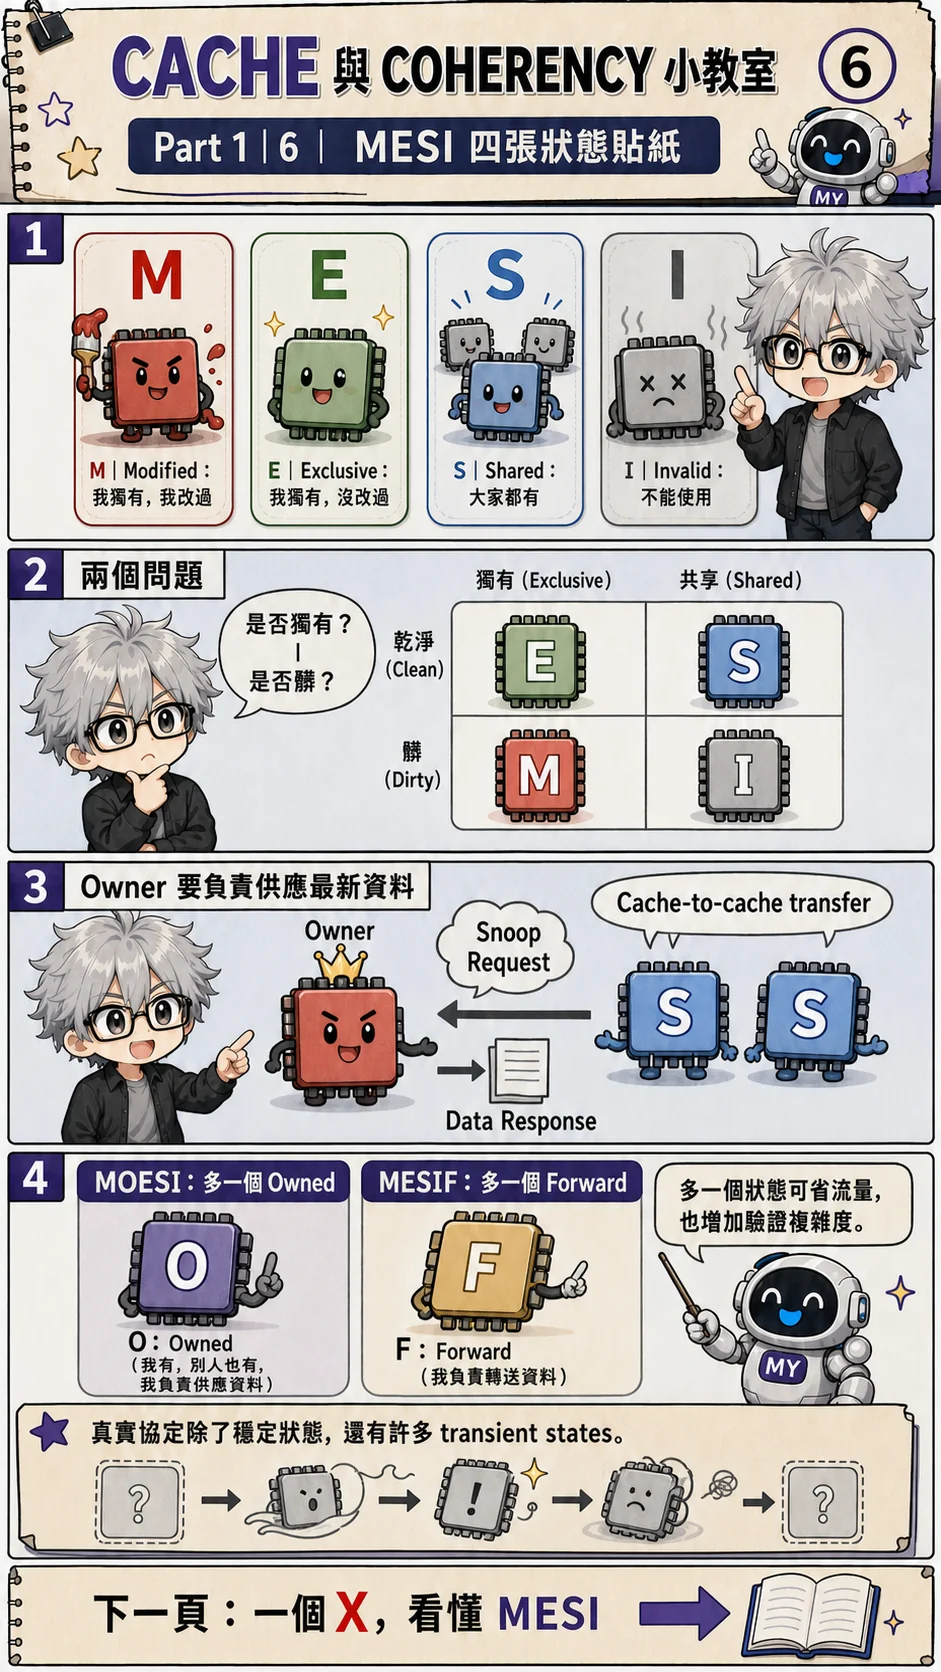
控制器看到一份資料,必須知道它能不能讀、能不能寫,以及下一層是否還有最新值。MESI 用四種狀態回答這些問題。Modified(M)是獨有且已修改;Exclusive(E)是獨有且乾淨;Shared(S)是乾淨、可能與別人共享;Invalid(I)表示這份副本不能使用。[2]
回到 X 的例子。若核心拿到乾淨且獨有的副本,它可以持有 E。它稍後修改 X,就進入 M。另一顆核心想讀這條 line,協定便要重新安排資料與權限。M 的持有者可能負責供應最新值,因為主記憶體仍可能保留較舊內容。Cache-to-cache transfer 描述快取之間直接交付資料的路徑。
S 的意思是「允許共享」,不保證目前一定有第二份副本。I 也不是一種髒資料狀態。即使實體儲存格還殘留舊位元,這份內容已經無效。圖 6 的矩陣適合提醒讀者區分獨有與共享,但不能把 I 解讀成「共享且髒」。判斷能否使用資料,要依它的有效狀態。
四個字母描述穩定結果。真實交易還有等待資料、等待失效確認等中間階段。初學者先追蹤「誰可讀、誰可寫、誰供應最新值」,就能看懂狀態改變的目的;完整控制器還必須處理途中交錯的請求。
工程師延伸:MOESI、MESIF 與暫態
MOESI 增加 Owned,允許資料相對主記憶體仍髒時,由指定 owner 負責供應共享副本。MESIF 的 Forward 則協助指定共享副本中的回應者。這些規則分屬不同協定,不能把基本 MESI 的乾淨 S 直接套到所有延伸協定。[6]
Transient states 記錄尚未完成的交易。驗證必須涵蓋同時到來的讀寫、資料與確認回應的不同順序,以及資源不足時的處理。只畫四個穩定狀態,還沒有描述完整 RTL。
7. MESI 動起來:讀可以共享,寫必須先取得所有權
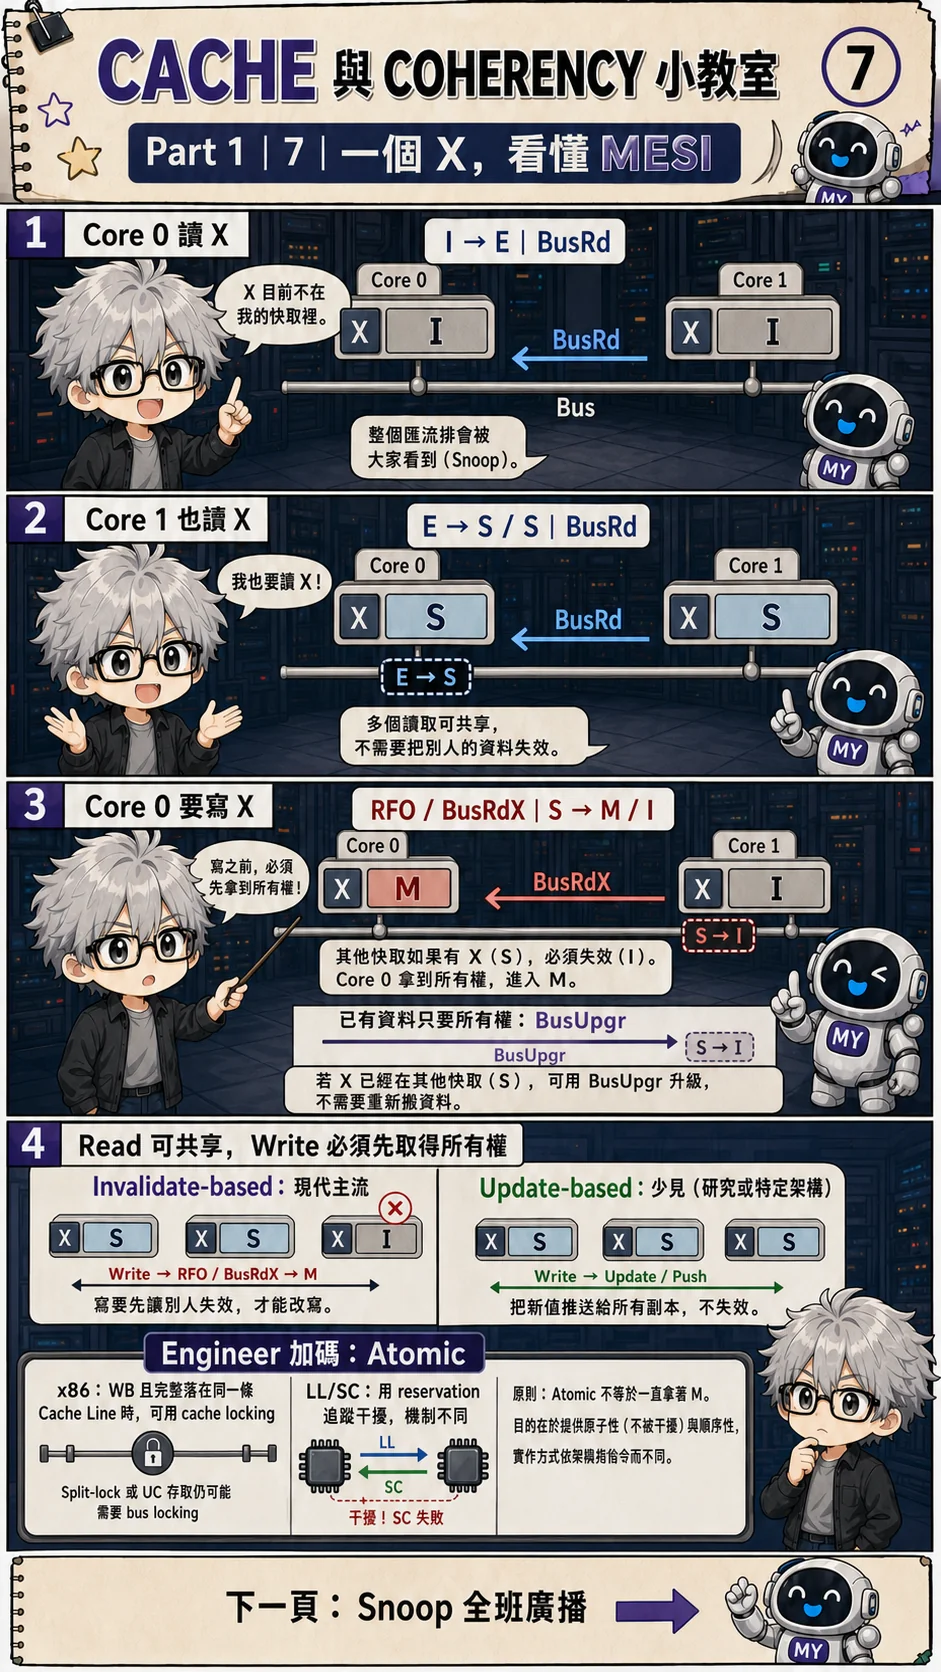
先假設兩顆核心都沒有 X。Core 0 的讀取未命中,發出圖中稱為 BusRd 的讀取請求。若沒有其他核心持有副本,它可以取得 E。Core 1 隨後也讀 X,協定允許兩邊保留 S。兩個讀者可在近處使用乾淨副本,無須輪流取得寫入權。[2]
現在 Core 0 要修改 X。它已有 S 資料,但還沒有獨佔寫入權。控制器要求其他 sharers 使副本失效,並等待協定要求的確認,才能完成權限交接。圖中的 BusUpgr 示範這種升級:資料已在發起者手上,只需要改變權限。它適用於發起者本身持有有效 S 副本的情況。
若發起者連資料也沒有,就要同時取得資料與寫入權,常用 RFO(Read For Ownership)或圖中的 BusRdX 表示。RFO 與 BusUpgr 因此不能隨意互換。BusRd 等名稱是教學用 bus 協定的交易名稱,現代互連可能使用不同封包與命名,目的仍是交付資料和管理權限。
採 invalidation 的協定先讓舊副本失效,後續讀者再需要時才取回最新內容。另一類 update-based 協定會傳送新值給其他副本。兩者的流量與等待方式不同。當程式頻繁輪流修改同一條 line,就算每次只改幾個 bytes,也可能反覆付出所有權交接成本。
工程師延伸:Atomic、LOCK 與 LL/SC
原子 read-modify-write 需要保證整個更新不可被另一個相衝突操作插入。Coherence ownership 提供基礎,但原子性仍由核心、快取控制器與架構規則共同保證,單看 M 狀態不足以判斷。[5]
x86 對可快取、未跨 line 的 write-back 記憶體鎖定操作,通常可使用 cache locking;split lock 或不可快取存取可能需要 bus locking。LL/SC 則使用 reservation,store-conditional 可能因干擾或其他允許的原因失敗,程式必須依架構規則處理重試。
8. Snoop:全班廣播很簡單,人多就很吵
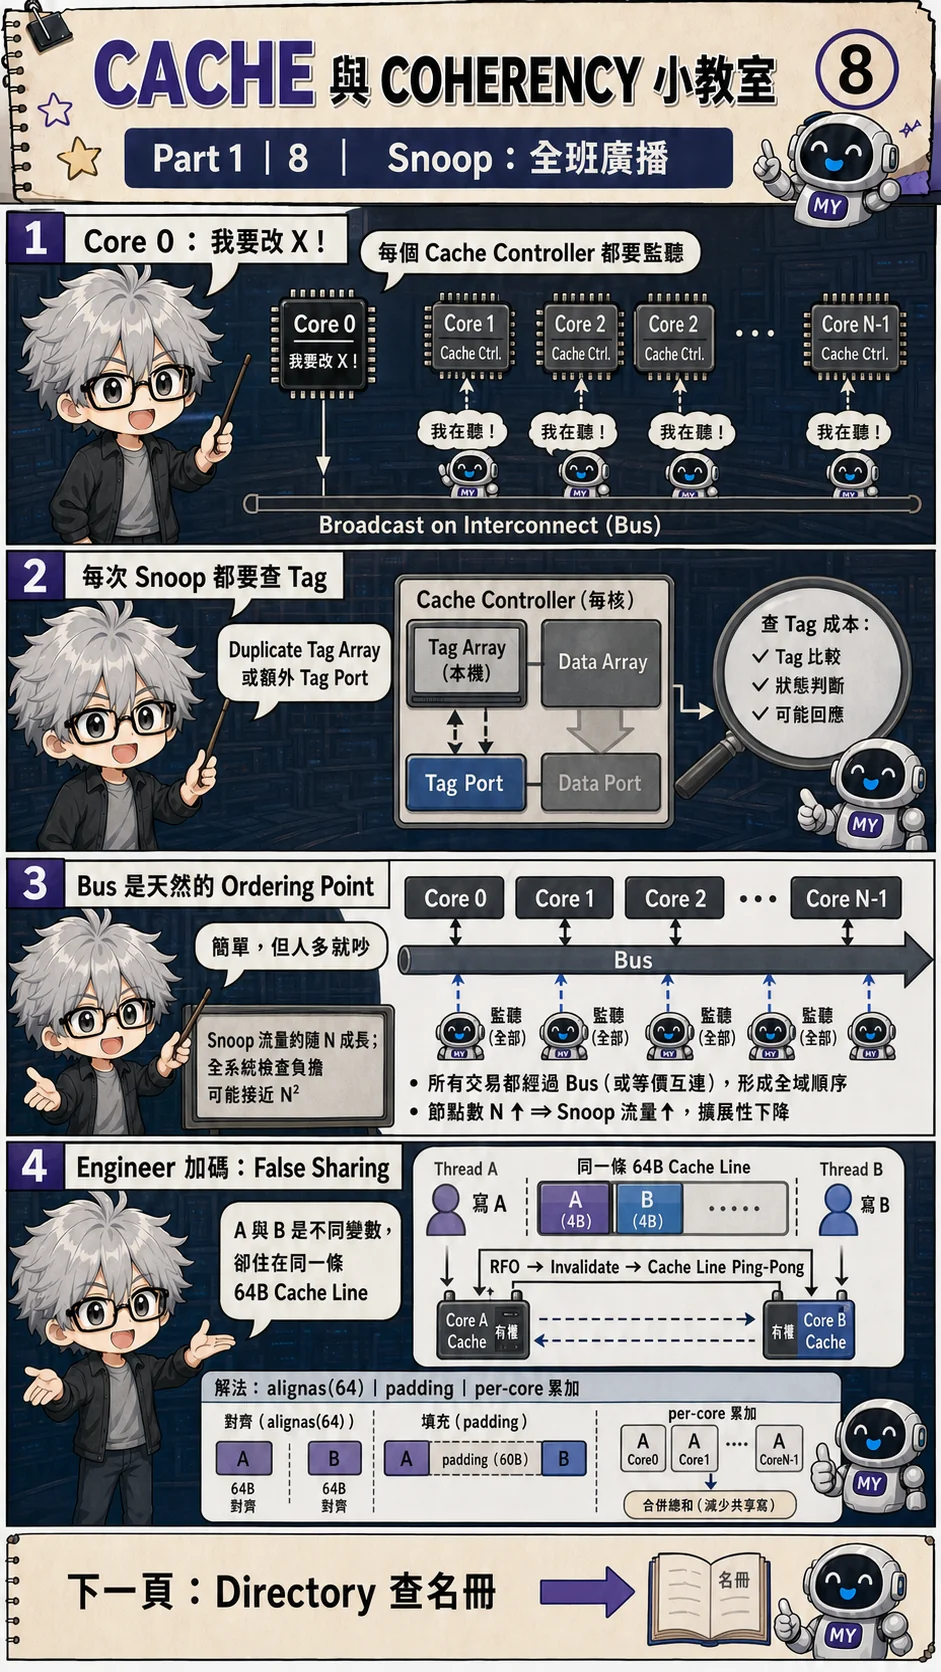
取得寫入權之前,控制器得找出誰還留著副本。Snooping 像全班廣播。Core 0 發出交易,其他快取控制器監聽互連,檢查自己的 Tag。持有相關 line 的控制器,再依狀態決定供應資料、降級或使副本失效。核心的軟體不需要逐一呼叫其他核心來清副本。[2]
這種做法的方便之處,是請求會送到可能的持有者。代價是許多接收者根本沒有這份資料,仍要參與檢查。控制器自己的 Tag 查詢也有成本。核心要讀資料時,若 snoop 同時需要查同一組資源,就可能產生競爭;增加查詢埠或複製 Tag 資料能改善競爭,但要增加電路。
傳統共享 bus 還提供共同的交易排序點。小系統容易利用這個順序管理權限;參與者增加後,共享通道與廣播檢查卻可能變成瓶頸。圖中的流量成長只表達擴充壓力,具體成長率仍取決於各節點產生多少請求、互連是否複製訊息,以及 filter 的作用。
程式也可能放大這項成本。兩個執行緒各寫自己的計數器,看似沒有共用變數;若兩個計數器落在同一條 64-byte line,寫入權仍要來回交接。這稱為 false sharing。共享的是硬體搬運與管理的單位。讀同一份唯讀資料,則不會因為這件事產生相同的寫入權爭用。[3]
工程師延伸:怎麼避開 False Sharing?
先以 profiler 或適當硬體事件確認 line bouncing,再檢查欄位位址與實際 cache-line 大小。可考慮分離常被不同執行緒改寫的欄位、padding,或各執行緒累加後再合併。圖中的 alignas(64) 要搭配物件大小與排列方式檢查;起始位址對齊不保證內部所有欄位都分開。
Padding 會增加資料占用空間,可能反過來增加 capacity miss。若程式真的共同修改同一個值,則是 true sharing,不能只靠移動欄位解決。比較改動前後的相同工作量,才能知道成本是否真的減少。
9. Directory:不問全班,改查名冊
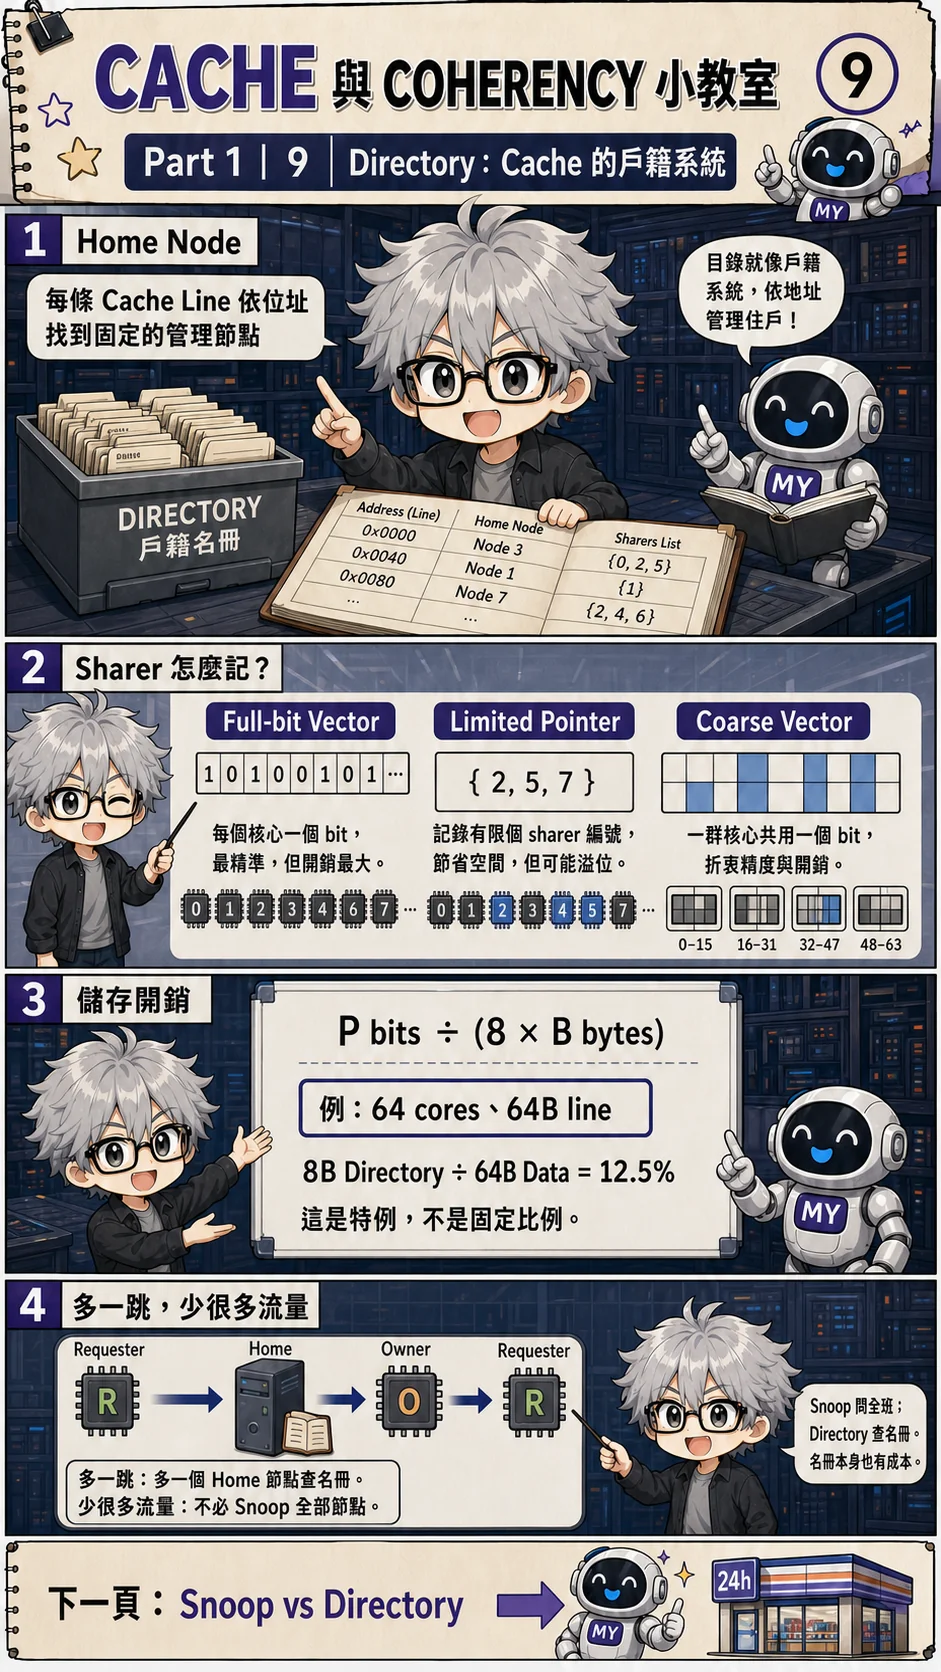
如果只有兩顆核心持有 X,為什麼每次都要問整台系統?Directory 用一份記錄,追蹤可能持有副本的節點。每條 line 的位址對應一個 home node。請求者先找 home;home 再通知相關 sharers,或尋找負責最新資料的 owner。這讓沒有參與的節點免於接收許多不必要的詢問。
名冊也得占空間。Full-bit vector 為每個可追蹤節點保留一個 bit。Limited pointer 只記少數節點,超出容量後要用其他處理方式;coarse vector 則以一個 bit 代表一群節點,節省記錄空間但可能多問幾個沒有副本的節點。選擇哪一種,會影響記錄精度與流量。[2]
圖 9 的算例假設 64 個可追蹤節點與 64-byte line。一條完整 bit vector 需要 64 bits,也就是 8 bytes;相對該 line 的 64 bytes,比例為 12.5%。公式是 P ÷ (8 × B),P 是 bit 數,B 是資料 bytes。這只算 sharer vector,未計 Tag、狀態與 ECC,也未描述目錄到底涵蓋多少條 line。
少廣播可能換來額外路程。資料若在另一個 owner 手上,請求可能沿 requester → home → owner → requester 前進。總成本要看路由、擁塞與回應,不保證 directory 每次都更快。當參與者很多時,它的優勢是比較能控制誰需要被通知。
10. Snoop 與 Directory:真實系統往往兩者混用
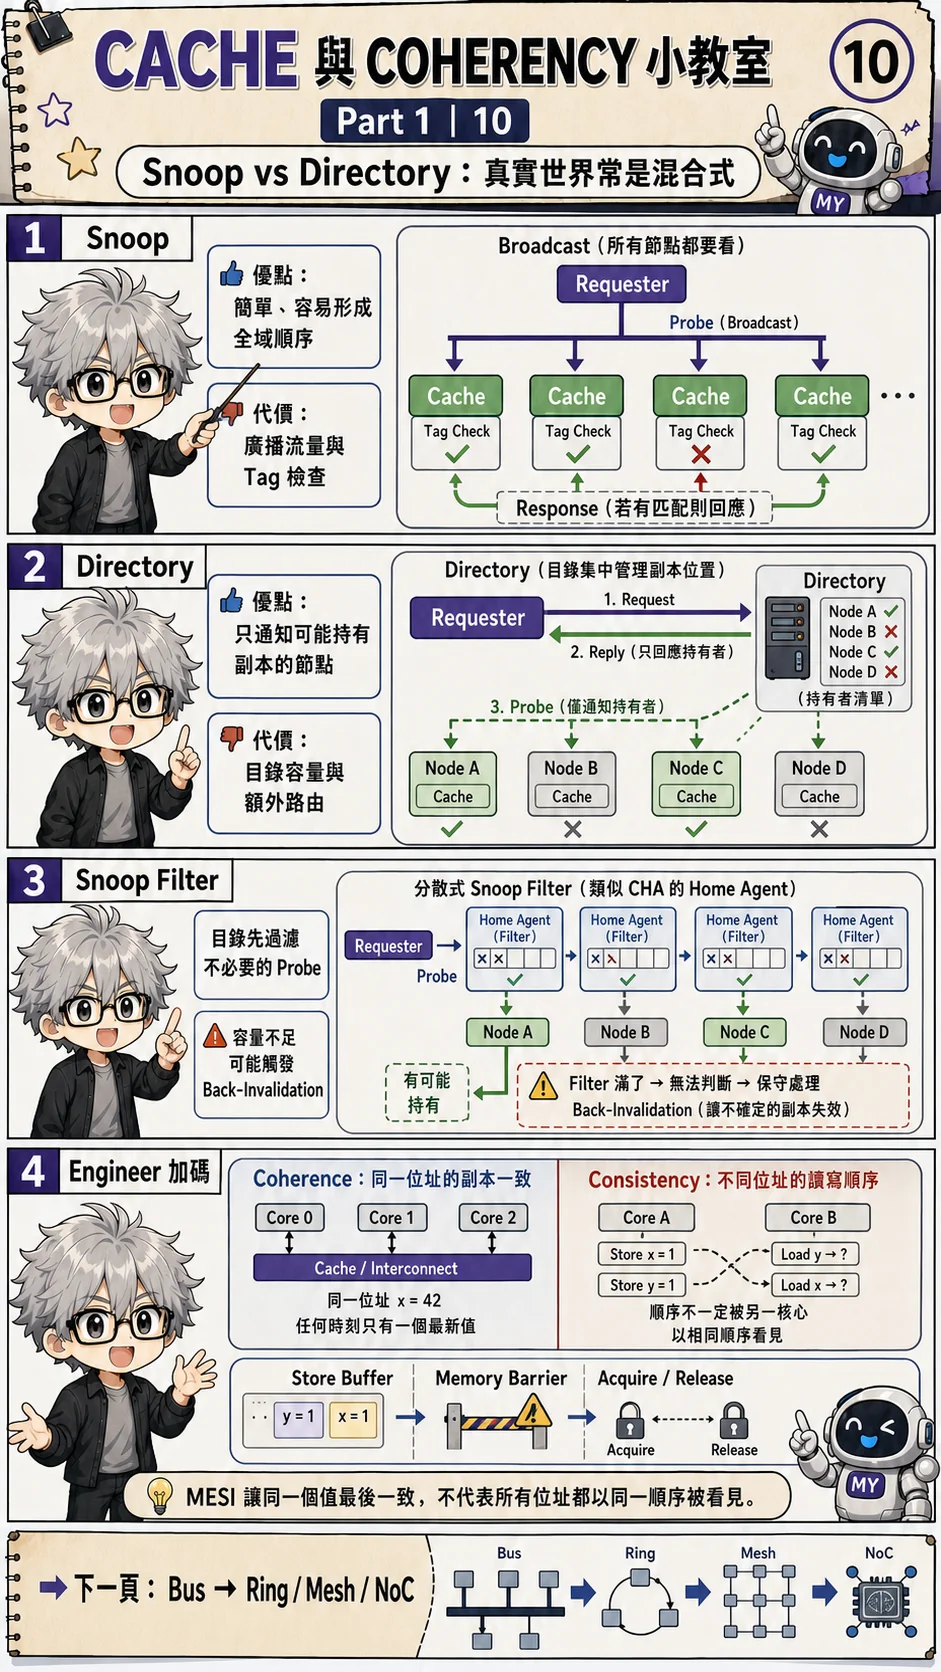
讀到這裡,可以把兩種方式放回同一個系統。小規模共享 bus 可直接 snoop;較大的互連可用 directory 記錄,再向選出的節點發 probe。實際處理器也可能採分散式 home agent 與 snoop filter。它們把追蹤副本和傳送訊息分工,減少不必要的廣播。
Filter 的首要責任是不能漏掉可能持有有效副本的節點。多問一個節點通常只是增加流量;漏問持有者卻可能破壞資料正確性。有些設計在 metadata 容量不足或淘汰時,先讓對應私有副本失效,稱為 back-invalidation。因此,資料還放得下,也可能因追蹤記錄不足而失去快取命中。[2]
還有一個程式層的問題。某個執行緒寫好結果,再發出「完成」旗標;另一個執行緒看到旗標後,希望讀到結果。結果與旗標是兩個位址。Coherence 處理每個位址的副本,兩個位址之間的可見順序則由 memory consistency model 與程式同步共同約束。只知道硬體有 MESI,還不能證明這段交接正確。[10]
安全的做法是使用語言與平台提供的同步機制,例如鎖,或正確配對的原子 release/acquire。這些機制同時要約束編譯器與處理器允許的行為。圖上的讀寫順序是在說明這個差別,不能直接翻成沒有同步的 C/C++ 普通共享變數,當作可用程式。
工程師延伸:Coherence 與 Memory Consistency
x86 TSO、Arm 的記憶體模型與 RISC-V RVWMO 各有具體規則;「較弱排序」也不表示彼此完全相同。Store buffer、write combining 與亂序執行會影響可觀察順序,軟體必須依語言與 ISA 規則選擇原子操作或 fence。
在 C/C++ 的合法訊息發布範例中,producer 先寫資料,再以 release 更新原子旗標。Consumer 用 acquire 讀到對應發布值,才依此建立需要的同步關係。Acquire 隨便讀到一個值,或只插入沒有配對關係的 barrier,都不足以保證這項交接。[10]
11. Bus、Ring、Mesh、NoC:Coherence 變成網路問題
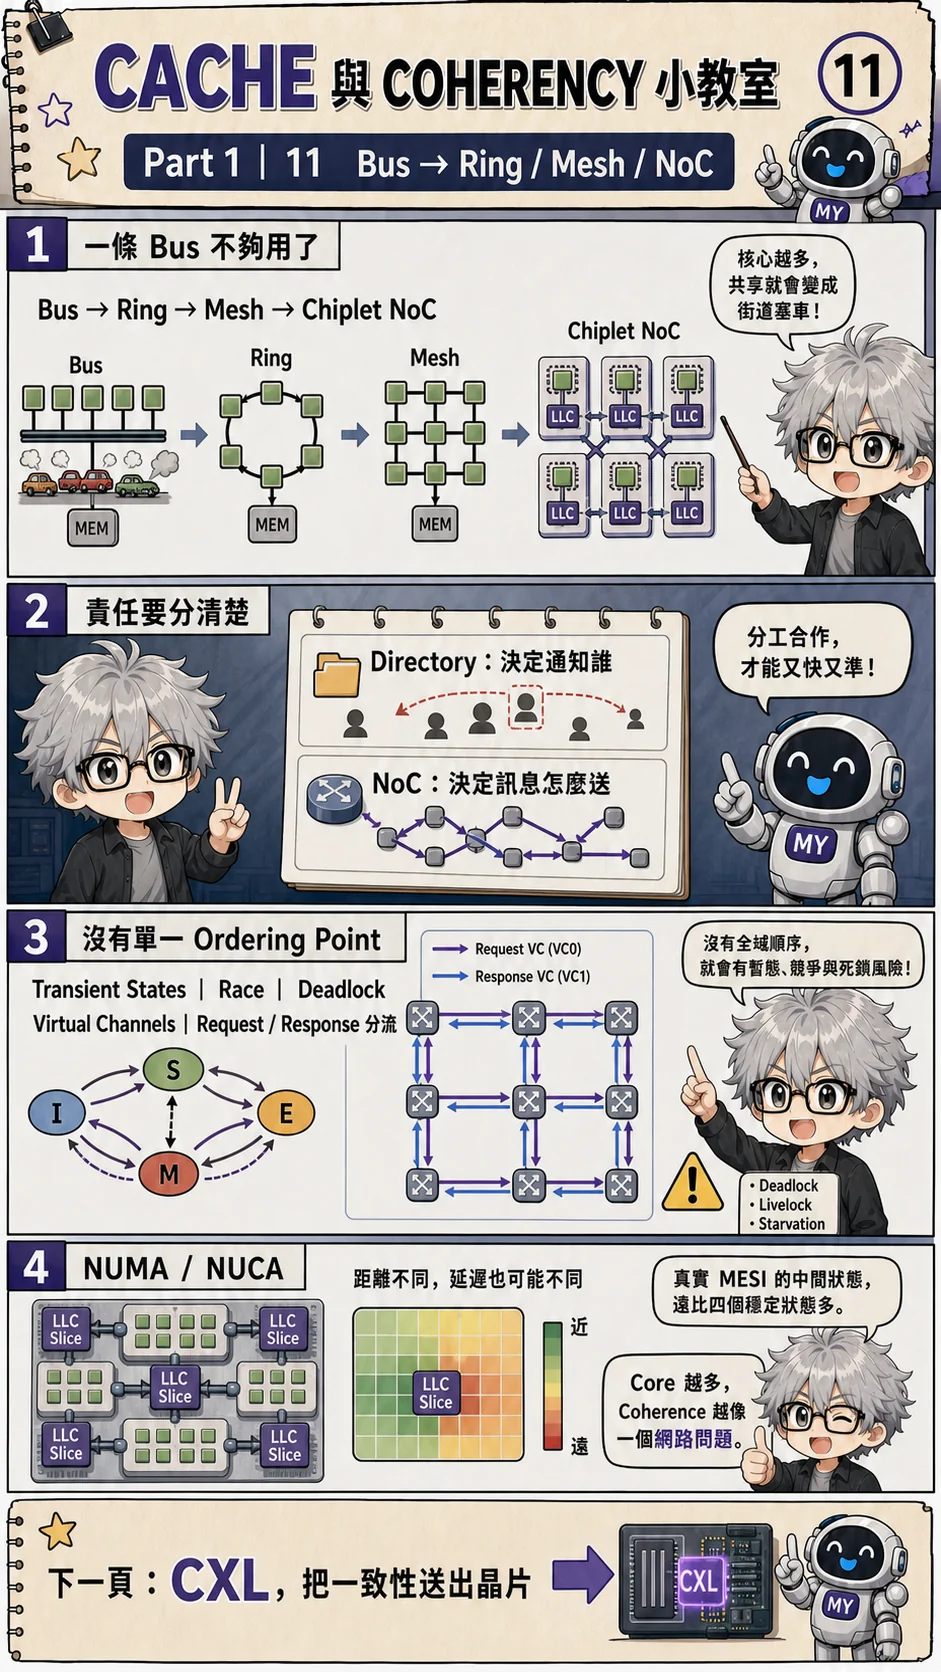
名冊告訴我們要找誰,訊息仍得送到對方。共享 bus 讓大家使用一條通道;ring 把節點串成環;mesh 則提供多條路徑。Network-on-Chip(NoC)是晶片內承載這些訊息的網路。拓樸改變訊息走法,也改變不同位置之間的距離與共享頻寬。
回到 Core 0 要寫 X。Directory 選出需要交接的持有者,NoC 傳送請求、資料與確認。控制器不能因為封包已送出,就假設所有其他副本已失效。訊息會在途中等待,也可能與其他交易交錯。權限交接何時算完成,必須由協定判斷。[7][9]
距離也會反映在效能。同一顆晶片上,不同 LLC slice 的存取可能有不同成本,稱為 NUCA。跨 socket 的主記憶體存取則常有 NUMA 差別。把執行緒與它常用的資料放在合適節點,可能比只增加核心更有幫助;具體改善仍需要量測。
多核心於是同時面對快取權限與網路資源問題。一個請求要走幾跳、通道是否擁塞、回應是否能前進,都可能影響開場的工作。核心旁邊的快取很快,也不能免除所有跨核心等待。
工程師延伸:訊息前進與死結
不同封包可能占住 buffer 或等待 credit。如果它們彼此等待對方釋放資源,就可能形成 deadlock。Virtual channels、分離 request/response 的網路,以及避免循環依賴的規則,都是常見設計工具;單純多加一條通道,並不自動構成無死結證明。
Retry、暫態與回應重排還要和 coherence 狀態機一起驗證。Arm CHI 描述可擴充一致性互連的交易規則;gem5 Ruby 可用於研究相關控制器與網路模型。模擬通過幾個範例,仍不能代替完整硬體驗證。
12. CXL:同一個副本問題,走出晶片
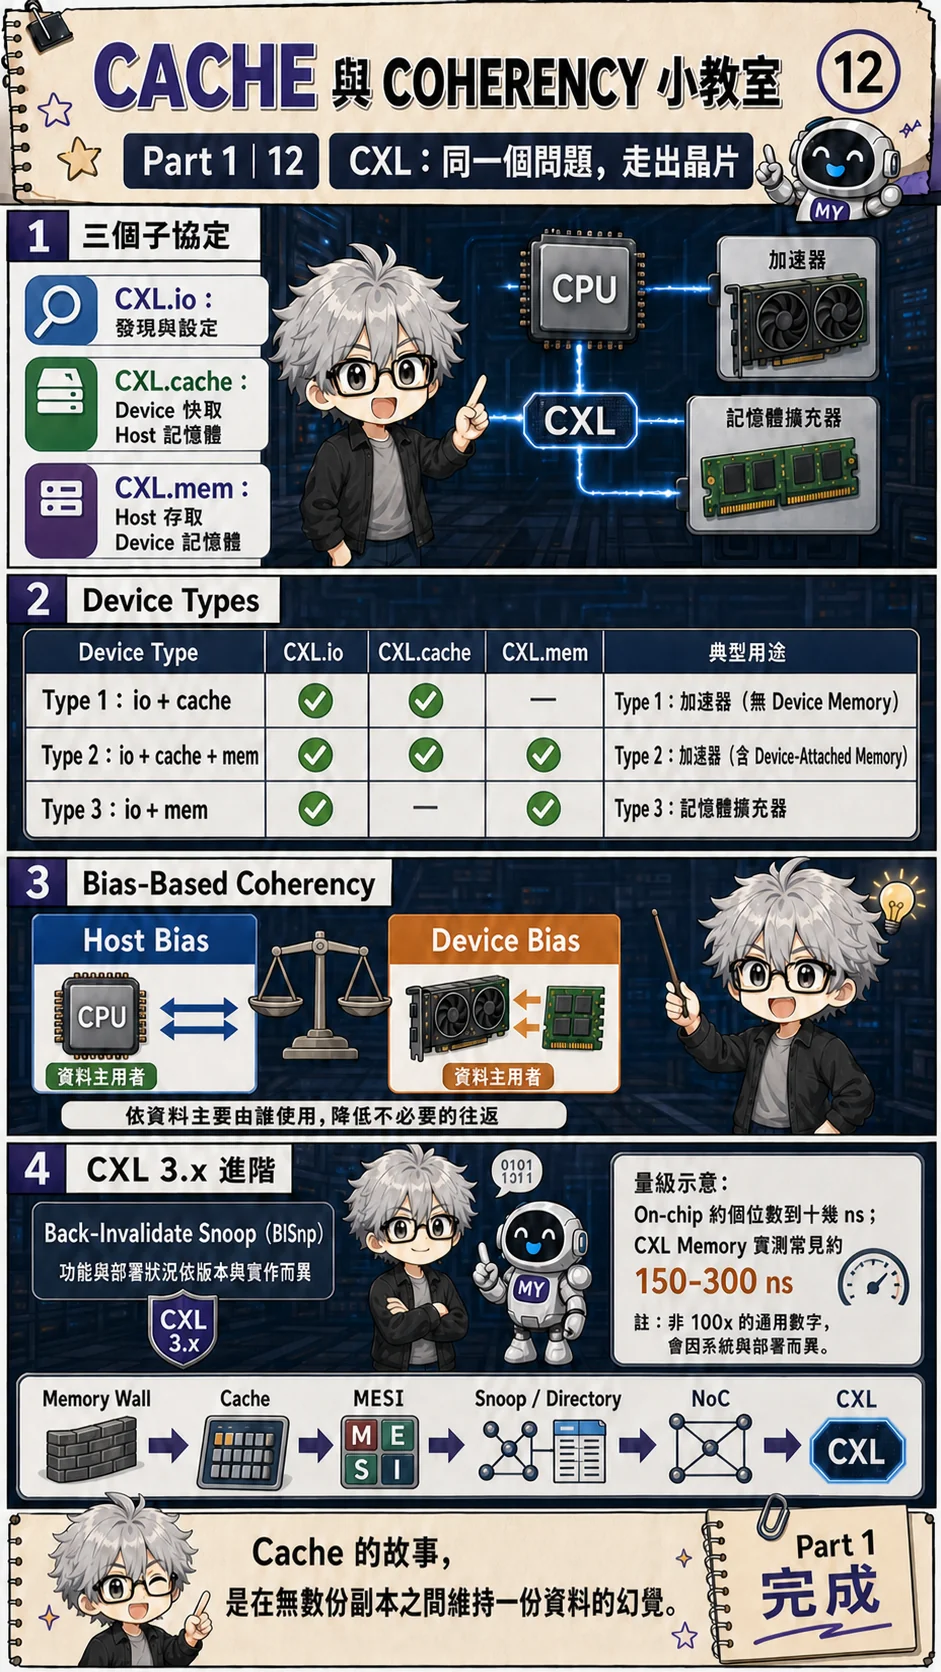
把處理資料的參與者放到晶片外,問題仍然存在。CPU 與加速器可能需要讀寫相同資料;系統也可能想連接額外記憶體。CXL 提供不同的協定角色,讓這些存取能透過對應機制進行。它不表示每個裝置都有同一種快取,或所有裝置都共享完全相同的記憶體語意。
CXL.io 處理發現、設定與一般 I/O。CXL.cache 讓裝置快取 host memory;CXL.mem 讓 host 存取 device-attached memory。圖中的 Type 1 使用 io+cache,Type 2 使用 io+cache+mem,Type 3 使用 io+mem。這個入門分類幫助我們先判斷「誰在存取誰的記憶體」,實際能力還要核對規格與產品。[8]
例如,讀取同一批資料的加速器,需要考慮裝置副本如何參與一致性;記憶體擴充器則先帶來容量與存取路徑的問題。增加可定址容量不代表每次存取更快。舊圖的 150–300 ns 沒有附測試條件,不能當成 CXL 的規格保證或通用實測範圍。實測研究顯示,延遲會隨裝置與量測方法改變;核對數字時,也要看主機與拓樸。[11]
CXL 3.x 的 fabric 與 back-invalidate 等能力,也必須依版本與實作判斷。圖中把它們放在同一頁,是整理可研究的機制,不能假設每台 Type 3 裝置都有全部功能。到了晶片外,設計者仍要追蹤副本、存取權限與資料路徑,只是距離和參與者又增加了。
工程師延伸:Bias 是有版本邊界的機制
圖中的 Host Bias/Device Bias 是特定 CXL Type 2 協定情境的簡化,涉及 device-attached memory 的主機與裝置存取管理。它不是所有 CXL 裝置通用的「資料主人」開關,也不能任意套到 CXL.cache 的所有存取。研究新版本時,應核對該版本對 bias、coherence 與 back-invalidate 的具體規定。[8]
回到開場:該改資料,還是改硬體?
開場的工作沒有因增加核心而等比例加速,現在可以分幾種原因檢查。反覆從遠處拿相同資料,先看重用與命中;不同核心輪流寫同一條 line,先看所有權交接。若只改各自的變數,仍發生 line bouncing,便要檢查資料排列是否造成 false sharing。這些假說要用相同輸入與量測範圍驗證,不能只憑核心數下判斷。
再改一個條件。若所有核心只讀同一份不變資料,它們可以保留共享副本,無須為每次讀取輪流取得寫入權。這會減少一類交接,卻不保證沒有容量未命中、頻寬競爭或遠端存取。Coherence 維持副本使用的正確性;工作能否加速,仍要看資料路徑與程式的同步方式。
本課尚未推導完整記憶體模型、逐一列出暫態,也沒有建立可交付的控制器 RTL。可以接著從課程地圖的「記憶體順序與同步」或「NUMA 與互連」繼續,兩課目前仍在規劃中。想先看已發布的應用,則可閱讀 AI 推論架構小教室,觀察同樣的資料供應問題如何影響加速器。
References
-
John L. Hennessy and David A. Patterson, Computer Architecture: A Quantitative Approach, Morgan Kaufmann.
-
Vijay Nagarajan, Daniel J. Sorin, Mark D. Hill, and David A. Wood, A Primer on Memory Consistency and Cache Coherence, Second Edition (2020).
-
Ulrich Drepper, What Every Programmer Should Know About Memory.
-
Agner Fog, The microarchitecture of Intel, AMD, and VIA CPUs.
-
Intel, Intel 64 and IA-32 Architectures Software Developer’s Manuals.
-
Compute Express Link Consortium, CXL 3.1 Specification.
-
gem5, Ruby Cache Coherence Models.
-
Linux Kernel Documentation, Memory Barriers.
-
Yan Sun et al., Demystifying CXL Memory with Genuine CXL-Ready Systems and Devices, MICRO 2023. 實測條件與裝置差異;不是通用延遲保證。
Hashtags
#Cache #CacheCoherence #MESI #MOESI #MemoryWall #AMAT #CacheLine #Locality #RFO #Snooping #SnoopFilter #DirectoryProtocol #FalseSharing #MemoryConsistency #NoC #NUMA #CXL #CPUArchitecture #漫畫小教室
學習指南
CPU 與記憶體系統
先備知識
- 基本 CPU、Load/Store 與記憶體階層概念
我學會了什麼
- 說明 Memory Wall 如何催生 Cache 階層
- 用 SWMR 不變量解釋 MESI
- 比較 Snooping、Directory 與混合式 Filter
- 區分 Coherence 與 Memory Consistency
- 辨識 False Sharing 與 CXL 裝置角色