一台機器轉得快,另一台能同時轉很多張
照片工作室準備換伺服器。兩台候選機器的核心數差很多,公開綜合分數卻接近。客戶有時只送一張急件,有時整批上傳。工作室該選單張處理較快的機器,還是核心更多的機器?先想想:同樣的總分,能回答這兩種需求嗎?
這是教學情境,不是產品實測。本課接續單核 CPU 的 IPC 與等待問題,改看多顆核心怎麼分工。一路追到共享資料、AI 工作流與成本,最後回到選機器的決定。
閱讀方式:漫畫先抓住每節的問題;內文解釋條件、算例與判斷。圖中的演講觀察會標示來源,教學數字不代表產品實測。
為什麼 CPU 又成為討論焦點?
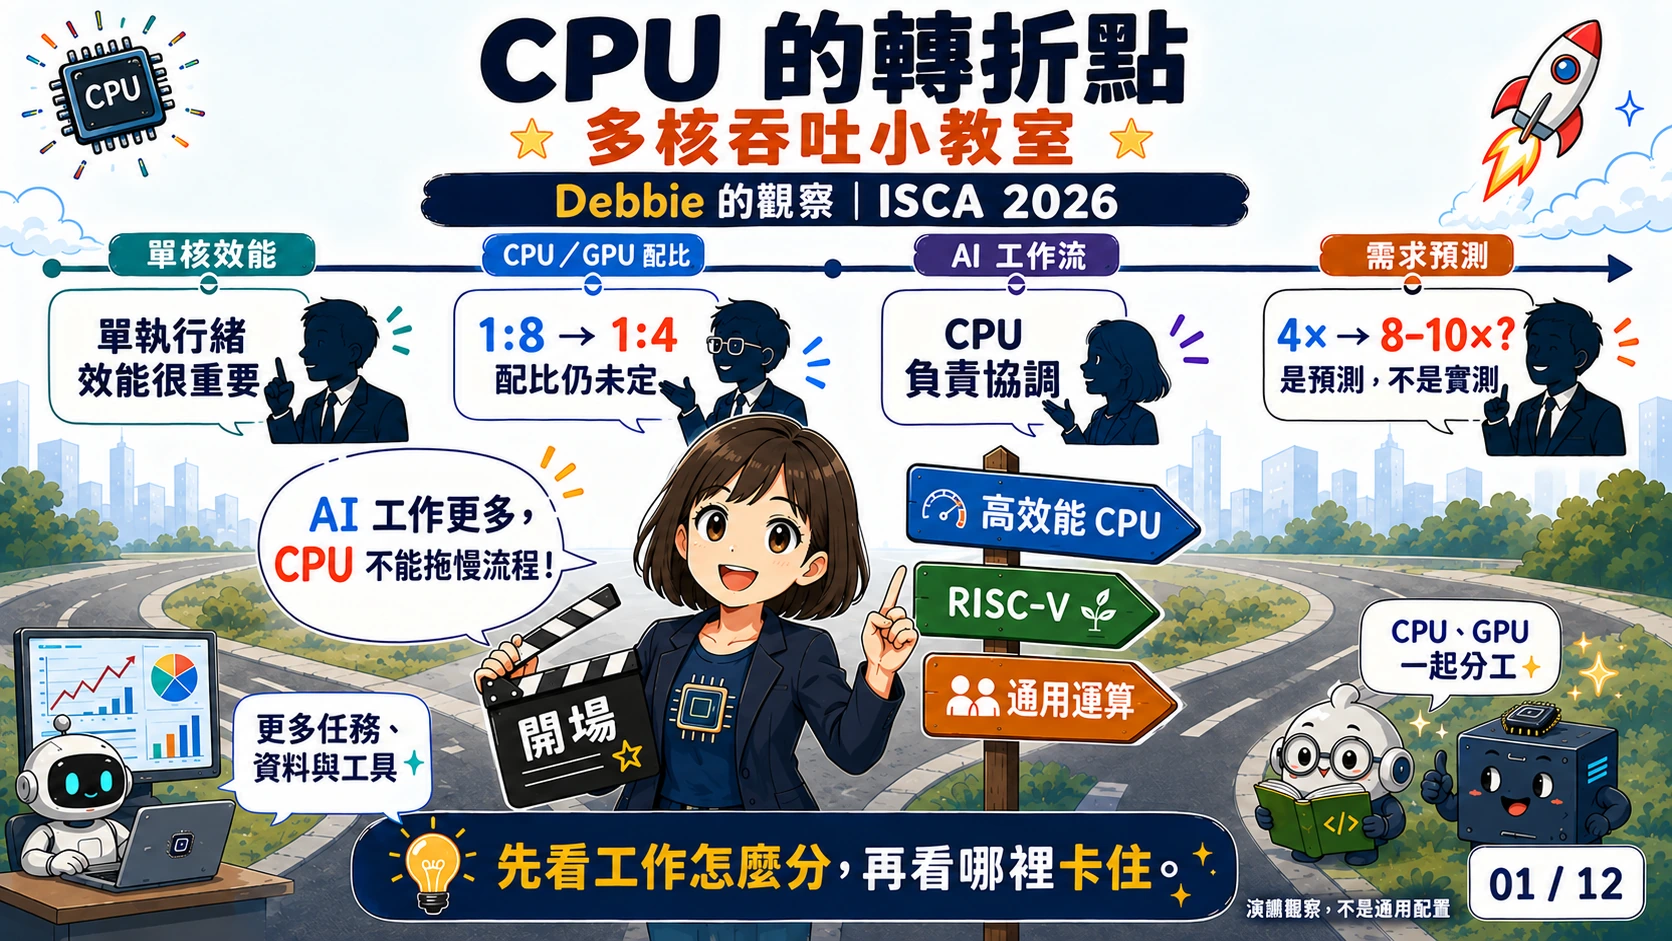
GPU 執行模型運算,為什麼討論 AI 時還要關心 CPU?如果資料準備、工具呼叫或工作安排拖慢後續步驟,單靠增加 GPU 不一定能改善完成率。Debbie 的演講由這個需求變化談起,強調 CPU 效能值得重新檢查。這是一個設計問題:昂貴的運算資源是否拿得到下一份工作?
開場圖整理的是 ISCA 2026 演講當時轉述的觀察。CPU/GPU 配比不是通用配置。Debbie 也轉述一項核心需求預測:原先談的四倍需求,後來被描述為八到十倍;這不是在四倍基礎上再增加八到十倍,也不是本課量到的成長結果。接下來先從照片工作室量得出的延遲與完成率建立判斷,再回到 AI、ISA 與需求的延伸。[9]
先量哪一種效能:一件工作,還是一整批?
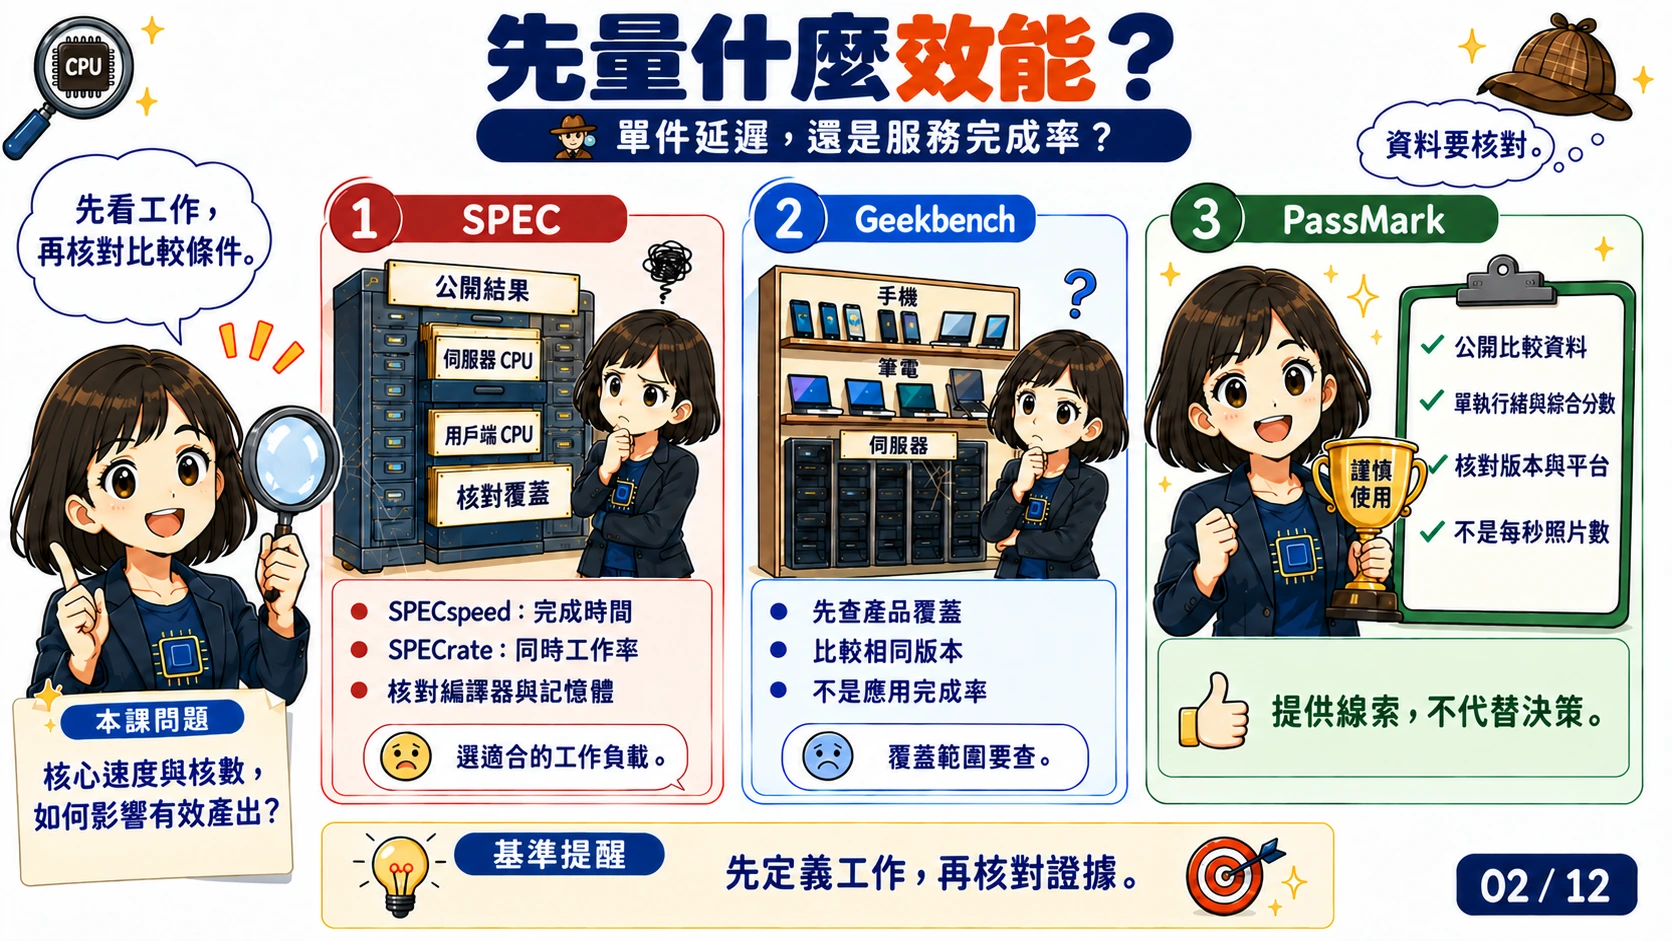
先用照片轉檔來區分兩種效能。使用者送進一張照片,想知道幾秒能拿到成品。這段等待是延遲。如果工作室每天有一大批照片,更在意每秒能完成幾張。這個完成率是吞吐量。加核心可能讓更多照片同時處理,卻未必縮短同一張照片的運算時間。兩個問題需要分開量。
標準基準也有類似區分。SPEC CPU2017 的 SPECspeed 著重完成工作的時間;SPECrate 以同時執行多份工作評估完成率。它們有明確的執行與報告規則,但仍受編譯器和記憶體系統影響。手機或伺服器只是產品類別,不能直接決定一套基準有沒有參考價值。[1]
本課保留的散點圖使用 PassMark 分數。單執行緒分數可提供特定測試下的效能線索;CPU Mark 則彙整多項測試。60,000 分沒有「每秒六萬張照片」的單位,也不能直接換成你的服務吞吐量。跨版本、作業系統或編譯條件的分數,更需要查清楚比較方式。[2]
所以工作室可以先用公開分數縮小候選範圍,再讓候選機器跑同一批照片。固定圖片尺寸與轉檔品質,記錄完成率和單張等待。最後核對輸出是否正確。若公開資料沒有涵蓋某個候選產品,也不能把缺少結果解讀成效能較差。測試能不能回答問題,要看實際工作與資料條件。
更多核心如何增加完成率?
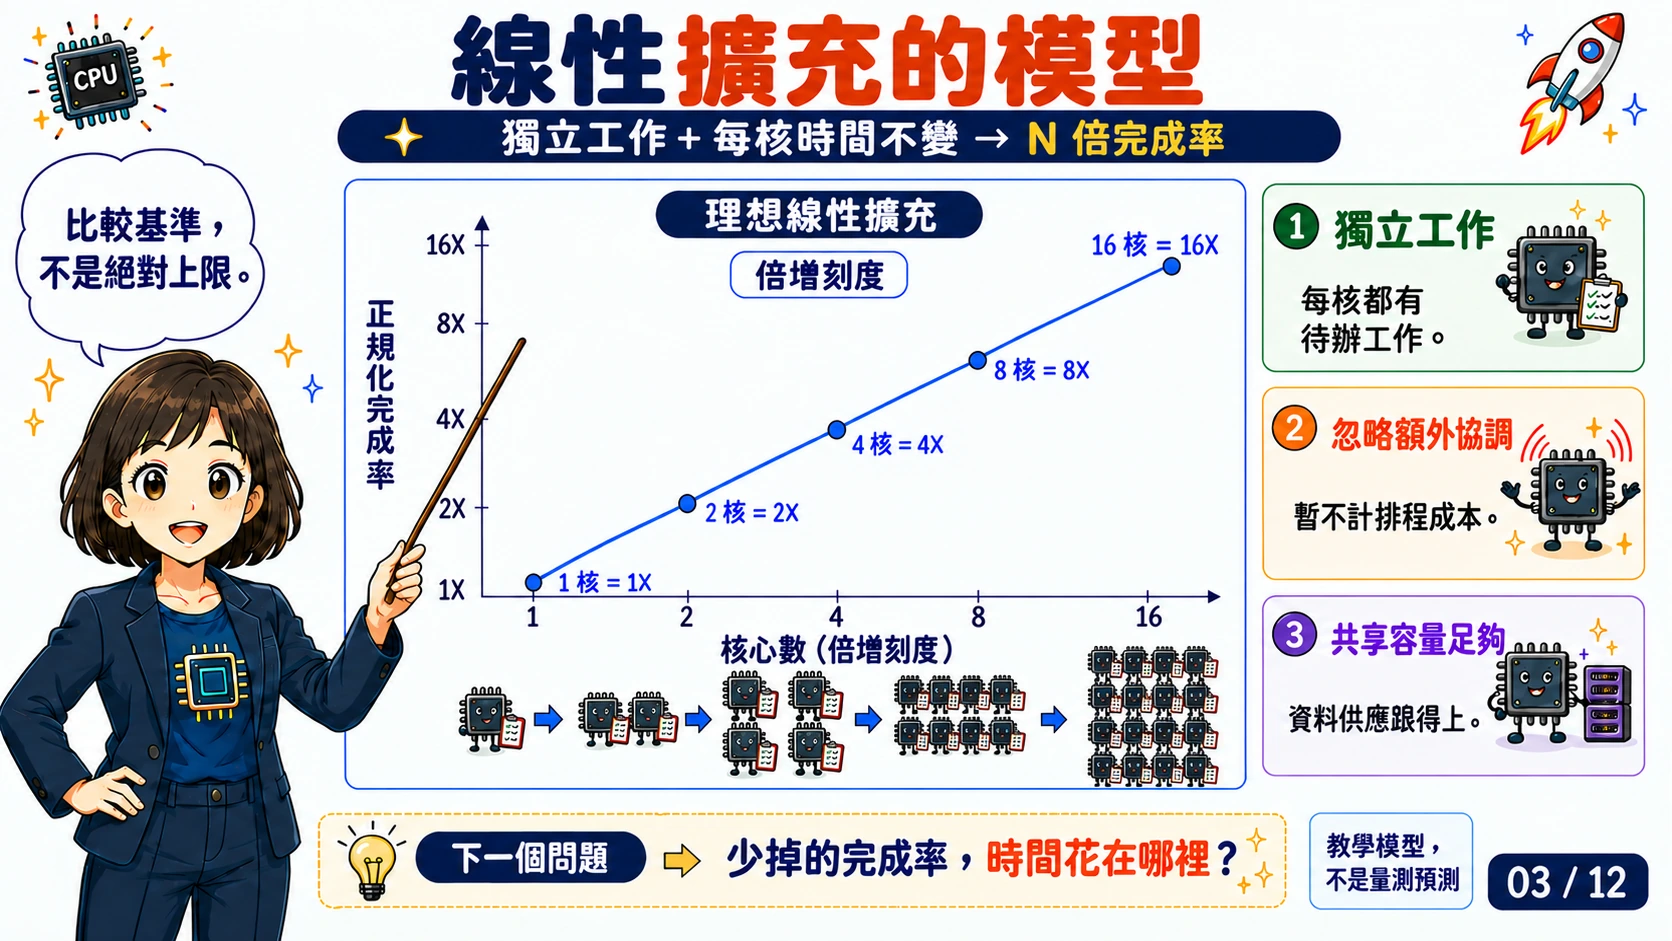
假設一顆核心轉一張照片需要一秒。照片之間沒有相依,佇列也一直有工作。這顆核心的理想完成率就是每秒一張。四顆同樣的核心,各處理不同照片,理想上可達每秒四張。每張照片的運算仍需一秒。吞吐量提高,單張的運算延遲卻沒有因此變成四分之一。
這個教學算例把資料供應與排程成本暫時拿掉。實際程式需要建立可同時執行的工作,再交給作業系統安排。四顆核心不能自行把一段有前後相依的程式切成四份。硬體執行緒也不等於實體核心;例如 SMT 讓執行緒共用部分核心資源,不能按執行緒數保證相同倍數的提升。
同一批 100 張照片,在前述理想條件下,一核需 100 秒,四核需 25 秒。這是整批完成時間的加速。若只有一張照片,仍由一核完整處理,就不會得到這個加速。服務有排隊時,額外容量還可能縮短排隊等待;因此使用者看到的總延遲,也可能下降。要分清排隊時間與真正運算時間。
圖中的線性曲線提供比較基準。量測若只有每秒三張,先確認工作是否足夠,再看各核心是否受到限制。核心全忙,不代表它們全在做有效運算;有些時間可能消耗在同步或等待資料。反過來,工作集能放進更多快取時,也可能出現高於簡化線性的結果。這條線的用途是檢查假設,不是替所有機器設定絕對上限。
同樣約 60K 分,為何不能換算成核心等價?
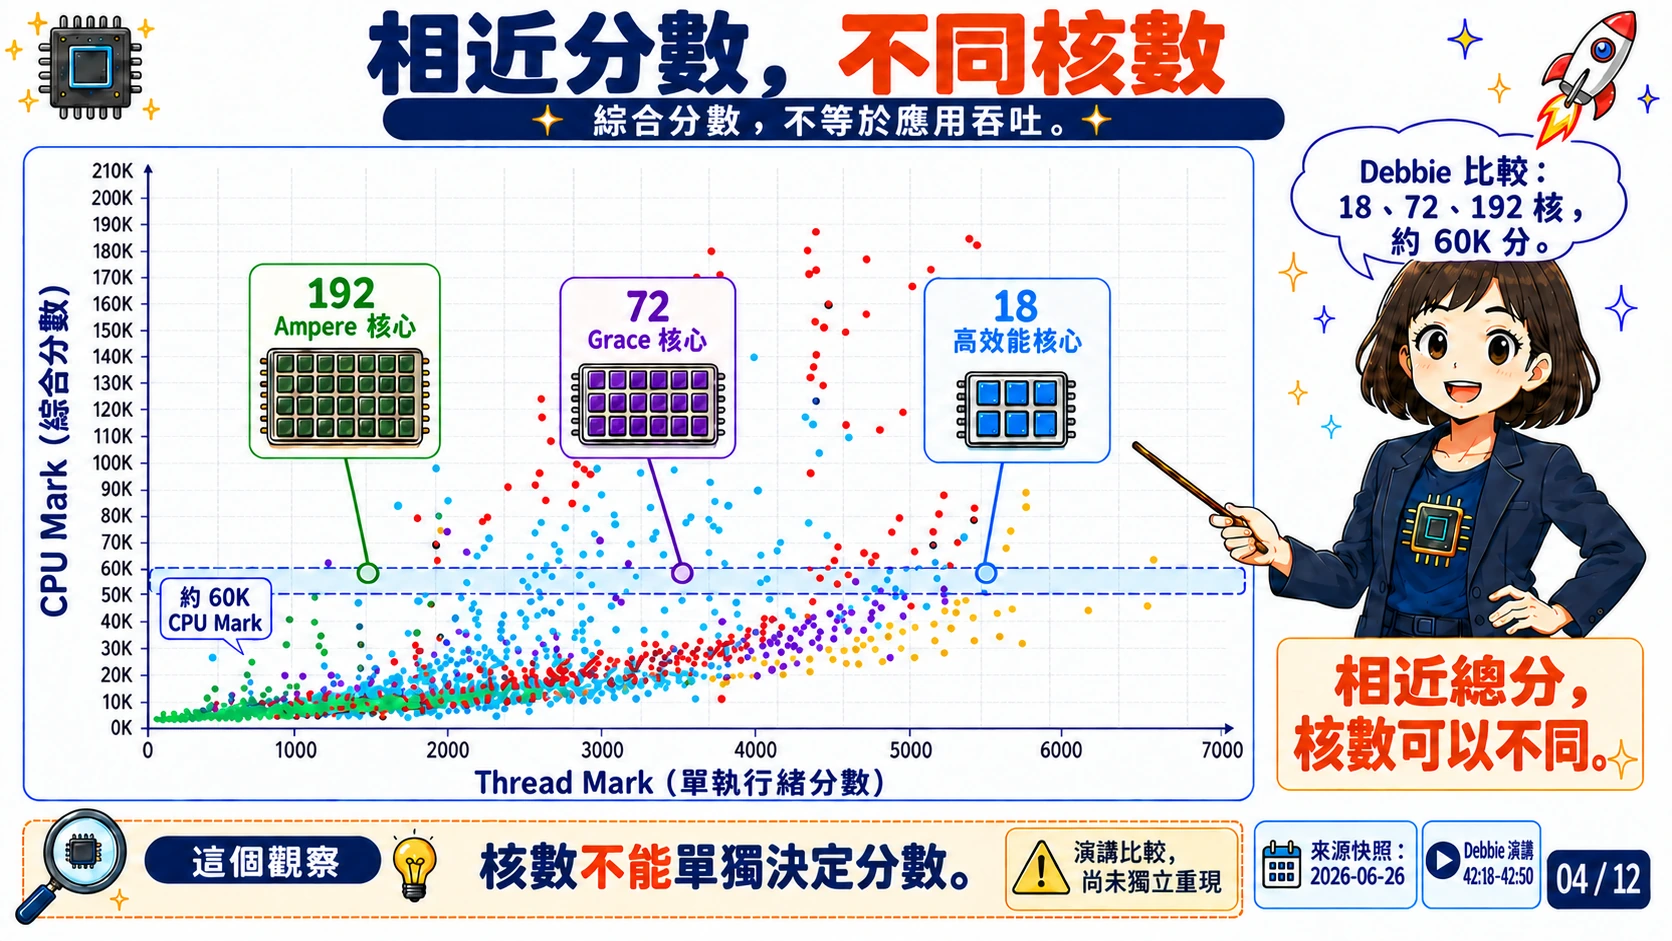
Debbie Marr 的演講在 42:18–42:50 用約 60K 分的水平帶,比較 18 顆高效能核心、Grace 的 72 核與 Ampere 的 192 核。圖板沿用這個觀察,提醒我們核心數和總分沒有一對一關係。這不是沒有來源的數字;但字幕並未提供完整點位清單、所有型號與測試設定。2026 年 6 月 26 日是舊圖標示的快照日期,不是本次重新量測。因此本課不把它當成已獨立核對的產品等價,更不由此推論某種架構每核快十倍。[9]
把問題換成可驗算的教學例子。機器 A 有四核,每核每秒完成兩張照片;機器 B 有八核,每核每秒完成一張。若工作獨立且資料供應足夠,兩台理想完成率都是每秒八張。A 的單張運算時間是半秒,B 是一秒。相同總完成率可以搭配不同的單張延遲;客戶若有交付期限,這個差異很重要。
實際多核執行時,每核表現還可能改變。全核運作的頻率可能低於單核加速頻率,核心也可能共用快取與記憶體。用單執行緒測試分數直接乘上核心數,就會漏掉這些條件。若不同核心大小混用,還要分別估算每一類核心的工作率,不能把全部核心當成相同的單位。
比較機器時,可以把吞吐量看成各工作者有效完成率的總和,再檢查共享資源是否讓這些完成率下降。這是一個分析起點,不能替代實測。回到照片工作室,應比較相同品質下的每秒完成張數、交付等待與成本。圖上的相近分數只提供待查線索,並未回答哪台機器最適合這份工作。
加核心後,時間消耗在哪裡?
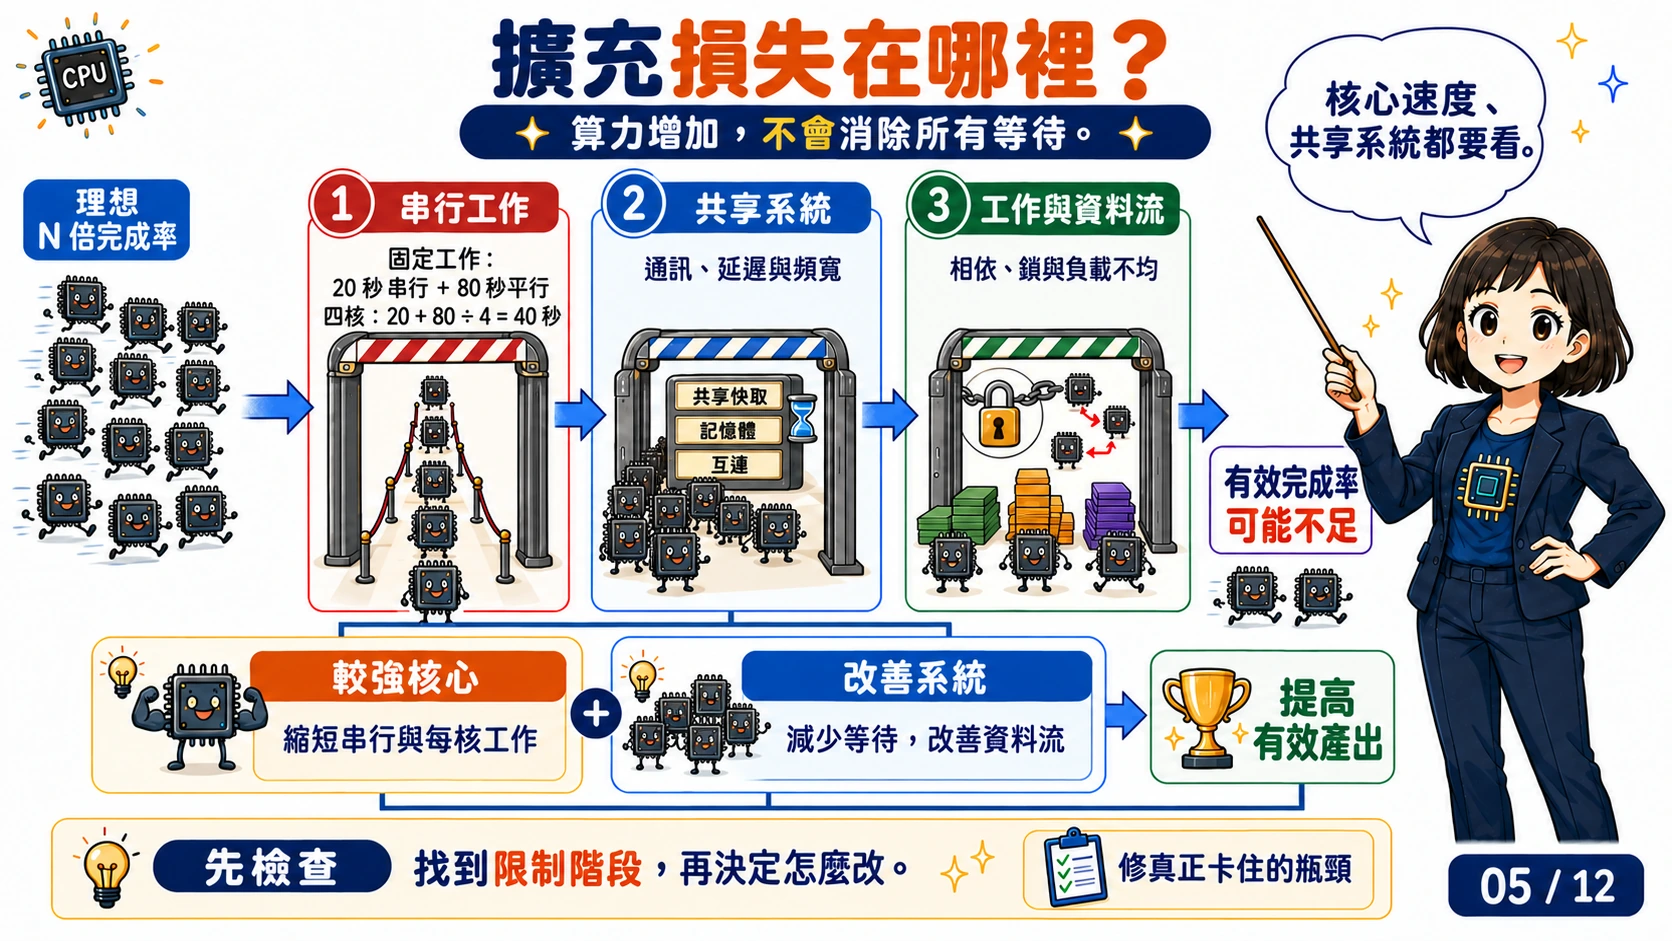
照片處理若變成一份必須一起交付的工作,串行步驟就可能限制整批加速。假設單核做完需 100 秒,其中 20 秒的共同初始化必須依序執行;剩下 80 秒可以均分到四核。忽略額外成本,四核需 20+80÷4=40 秒,加速比為 100÷40=2.5。即使平行部分快到幾乎不花時間,那 20 秒仍留下五倍加速的上限。這是固定工作量的 Amdahl 模型。[3]
這個共同初始化與「每張照片各有自己的順序步驟」不同。後者仍可能讓不同照片分別在不同核心執行。Amdahl 算例限定一份工作的完成時間;持續接單的服務則要另外找共用瓶頸。例如所有照片都要經過同一個序列寫檔階段,這個階段若每秒只能完成兩張,前段增加再多核心也無法長期送出每秒八張。
共享資料通道也會限制擴充。若核心需要搬動大量圖片資料,記憶體通道可能先滿載。這時更多核心只會增加等待。另一種情況是多核反覆修改同一份共享狀態,必須維持快取副本一致,於是資料在核心之間來回傳。這些等待與單核執行指令的速度不同,不能全靠更高 IPC 解決。
工作分配不均則會留下空閒核心。把四張不同大小的照片固定分到四核,最後可能只剩處理大圖的核心還在忙。可把工作切得更細,或讓完成的核心再從佇列領取下一件。但切分和同步也有成本。量到瓶頸後,才知道要改善核心、資料布局,還是排程方式;單看 CPU 使用率,通常分不出這幾種原因。
工程師延伸:效率、NUMA 與 false sharing
固定工作量的加速比為 S(N)=T(1)÷T(N),平行效率為 E(N)=S(N)÷N。前述四核例子是 2.5÷4=62.5%。這裡的效率不是每瓦效能。多插槽或 NUMA 系統中,記憶體存取成本取決於資料所在節點;執行緒位置與資料配置需要一起考慮。不同變數若落在同一快取行,反覆寫入也可能引發 false sharing。這些是下一課 Cache & Coherency 要展開的問題,不能由總分直接判定。
效能如何走到產品價值?
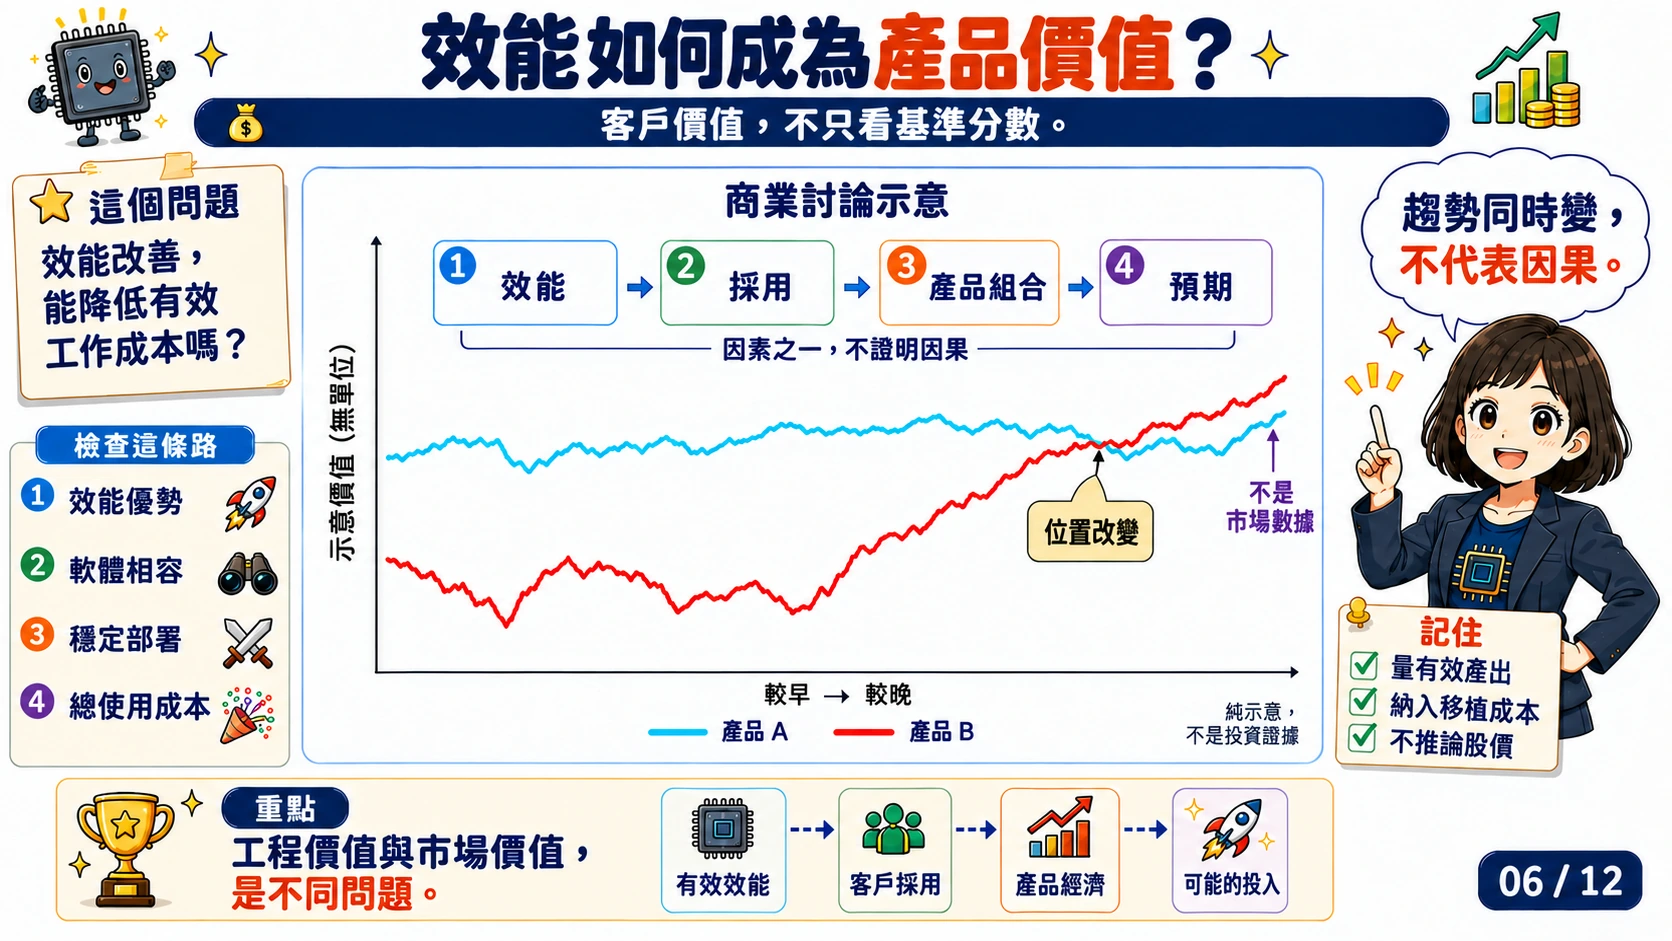
工作室選機器,最後要看能不能在預算內交付客戶需要的照片。效能的商業價值可以從這裡推算。假設一台機器只用一半數量就能完成相同品質與期限的工作,可能節省設備或機架成本。但這個好處要與購入價格、耗電及維護一起計算,不能從跑分高低直接得出。
處理器供應商也需要把效能轉成客戶願意採用的產品。客戶會考慮軟體能否運行,以及系統供應是否可靠。性能優勢若伴隨高昂移植成本,採用速度就可能受限。另一方面,軟體相容與長期支援可能讓較低峰值分數的產品仍有吸引力。這些是產品決策的條件,不是本課對任何公司的財務預測。
Debbie 的原演講用 Intel 與 AMD 討論效能領先和商業結果。這頁改用無單位的產品 A/B 曲線,保留「競爭位置可能改變」的問題,不把它畫成已核對的市值紀錄。即使兩條真實趨勢同時變化,也不會自動證明因果;產品組合與製造策略都可能影響企業結果。市值又反映市場對未來的預期,與當期現金流不同。[9]
因此這頁的問題是:客戶為什麼願意為某種效能付錢?回到工作室,可以用每張合格照片的成本回答一部分,再檢查交付可靠性。供應商是否因此獲得更多營收或研發資源,需要另一組商業證據。圖板只是討論起點,不是投資建議,也不能支持「CPU 更快,市值必然更高」的推論。
AI 工作流中,CPU 何時真的讓 GPU 等待?
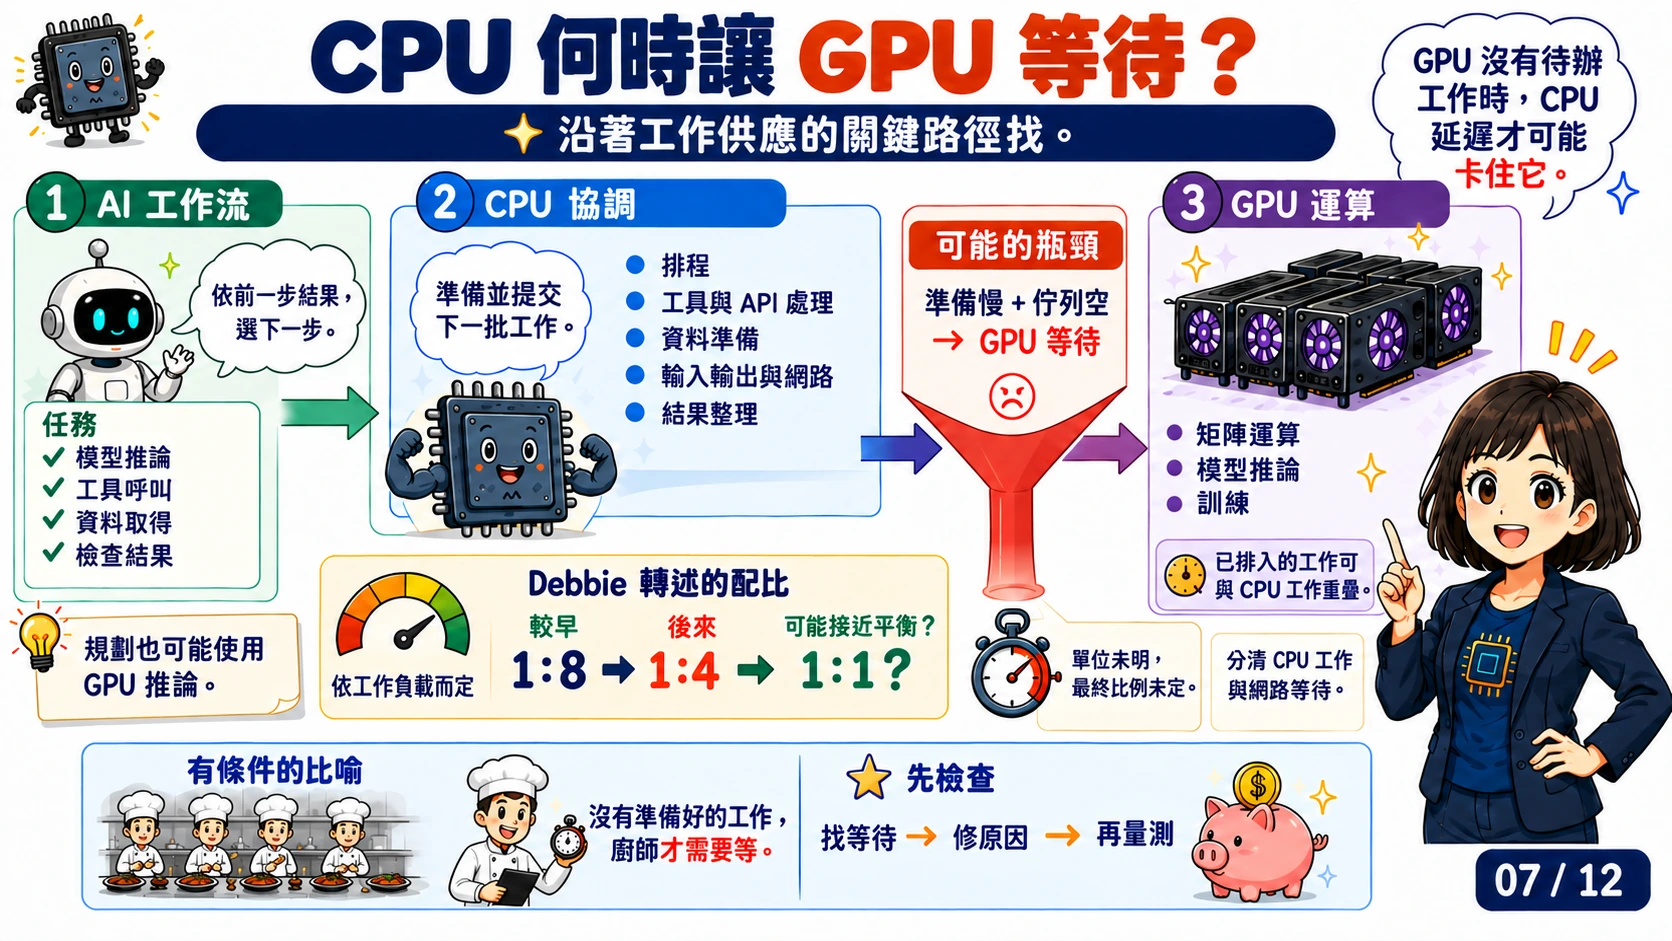
把工作室換成需要多步驟處理照片的 AI 服務。模型先辨識內容,程式再呼叫工具修改圖片,最後讓模型檢查結果。這種依結果選下一步的工作流,常被稱為 agentic AI。模型的辨識或規劃可能在 GPU 上推論;主機端 CPU 則可能負責接收請求與整理工具結果。兩者分工要看部署,不能把「理解與規劃」一律算成 CPU 工作。
假設下一批 GPU 輸入必須先由 CPU 準備,而 GPU 的既有佇列已清空。CPU 準備得太慢,GPU 就會等。這與照片例子的資料供應瓶頸相同。若 CPU 等的是遠端工具回覆,等待的根源可能是網路或外部服務。更快的核心未必能縮短這段時間,必須先追到真正的等待來源。
這個條件也說明圖中的廚房比喻何時不成立。GPU 可以執行已經送入的工作,同時 CPU 準備下一批。多個獨立請求也可能互相填補空檔。NVIDIA 的非同步執行文件說明這類重疊執行方式;實際能否重疊,仍有相依性與硬體條件。CPU 暫停一毫秒,不代表所有 GPU 都必然閒置一毫秒。[4]
Debbie 在演講 25:15–25:43 轉述 Intel 執行長談 CPU/GPU 配比:從 1:8 到 1:4,可能走向接近 1:1;她隨後也明說,最後會是多少,她不知道。這是有來源的產業觀察與預測,不是所有 AI 系統的配置定律。這段字幕沒有界定 CPU 是整顆處理器、核心數,還是別的統計單位。因此應先量出 GPU 是缺工作、等資料或已滿載,再決定 CPU 容量。不能拿這三個比例直接選設備。[9]
RISC-V 的機會,要怎麼用工程證據判斷?
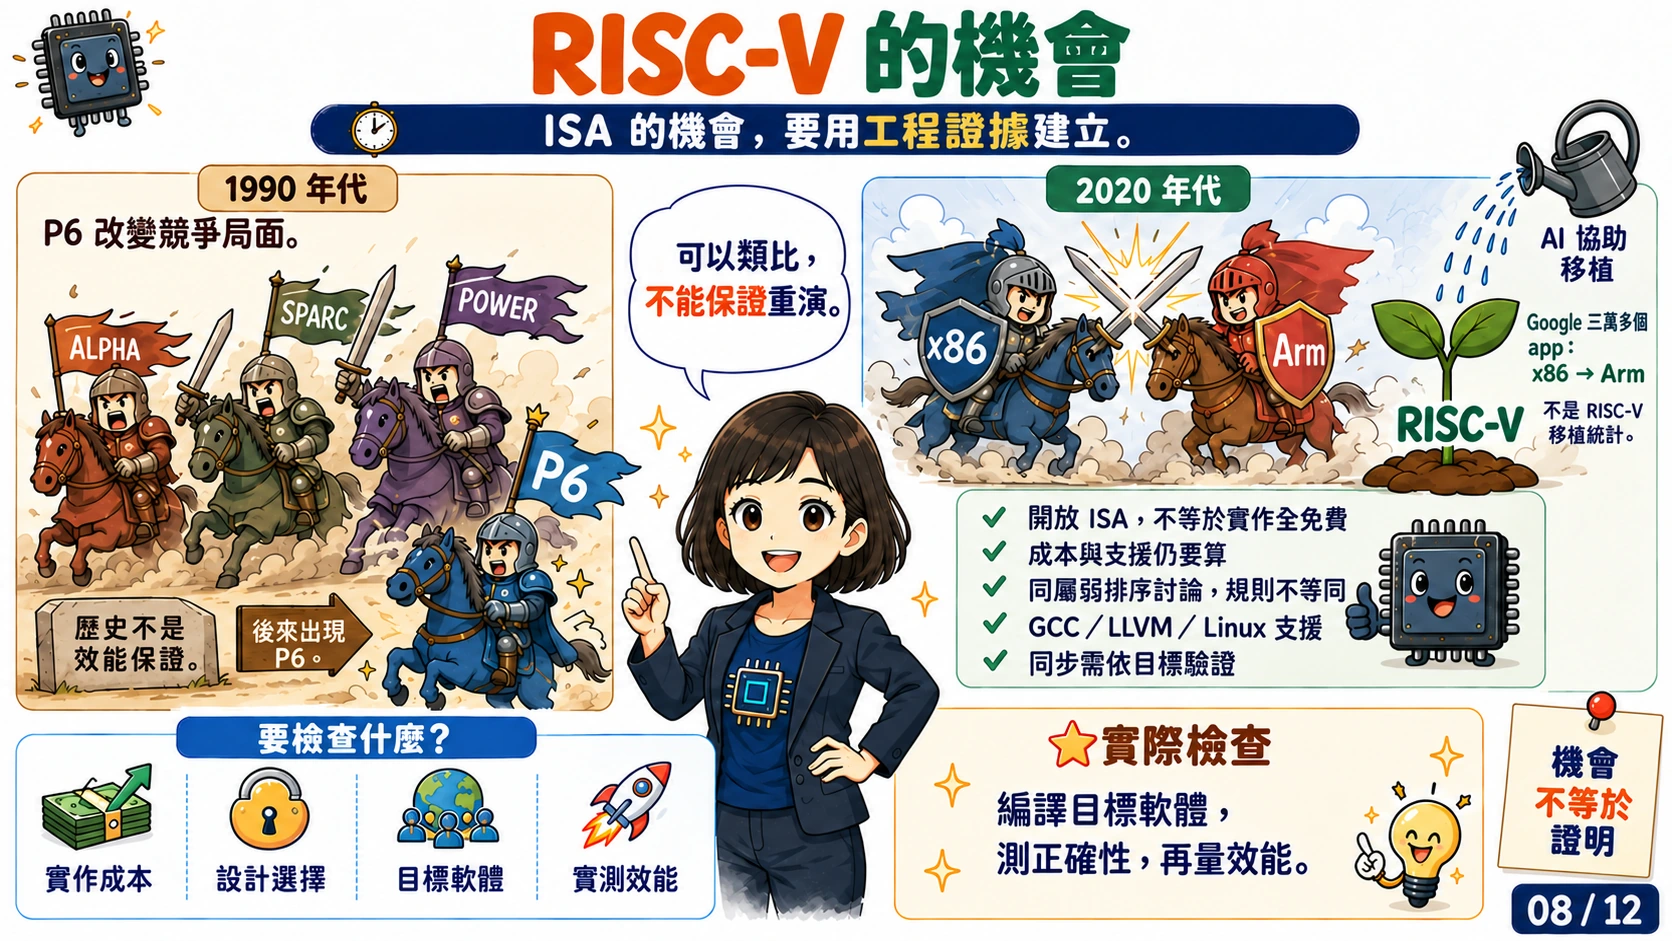
工作室若想換用 RISC-V 伺服器,第一個問題是同一套照片軟體能不能在那裡運行。指令集架構(ISA)定義軟體可使用的指令與可見行為。核心如何預測分支、安排指令與建立快取,是實作層的問題。同一 ISA 可以有小型核心,也可以有較複雜的核心。因此 ISA 名稱無法單獨預測單核延遲或多核完成率。
RISC-V 的開放 ISA 讓設計者有不同的實作選擇。使用 ISA 不代表整顆晶片或商用核心 IP 都免費;其他 IP 與軟體支援仍可能收費。GCC 提供 RISC-V 目標選項,能控制 ISA 擴充和 ABI 等條件。這是工具鏈存在的證據,但距離所有套件與最佳化函式庫都能直接移植,還有一段路。[5] [6]
多執行緒軟體還需要正確的同步。Debbie 在 54:39–54:57 先對照強排序與弱排序,再說 Arm 與 RISC-V 有共同的記憶體模型。依上下文,本課把它解讀為兩者都涉及弱排序、移植經驗可以參考;這是教學上的解讀,不代表知道她對每項規則的判斷。規格層次上,RISC-V 的基礎模型 RVWMO 與 Arm 的規則不能直接畫等號。RISC-V 官方移植指南也分別列出 Arm 的 acquire、release 操作如何映射。原子操作與同步仍需依目標架構驗證。[7] [9] [11]
圖中的騎士對決把 ISA 競爭畫成歷史故事,但「下一個 P6」仍只是類比。三萬多個應用程式則確有來源:Debbie 在 48:37–48:59 引用 Google 的移植工作,Google 原文也報告超過三萬個應用程式從 x86 移植到 Arm。它說明大規模 ISA 移植可以推進,不是 RISC-V 已完成同等移植的證據。工作室仍應檢查目標套件,再跑正確性與效能測試。AI 能協助修改程式,卻不能取代驗證;新 ISA 的機會要由這些條件逐項建立。[9] [10]
軟體變便宜,算力需求一定增加嗎?
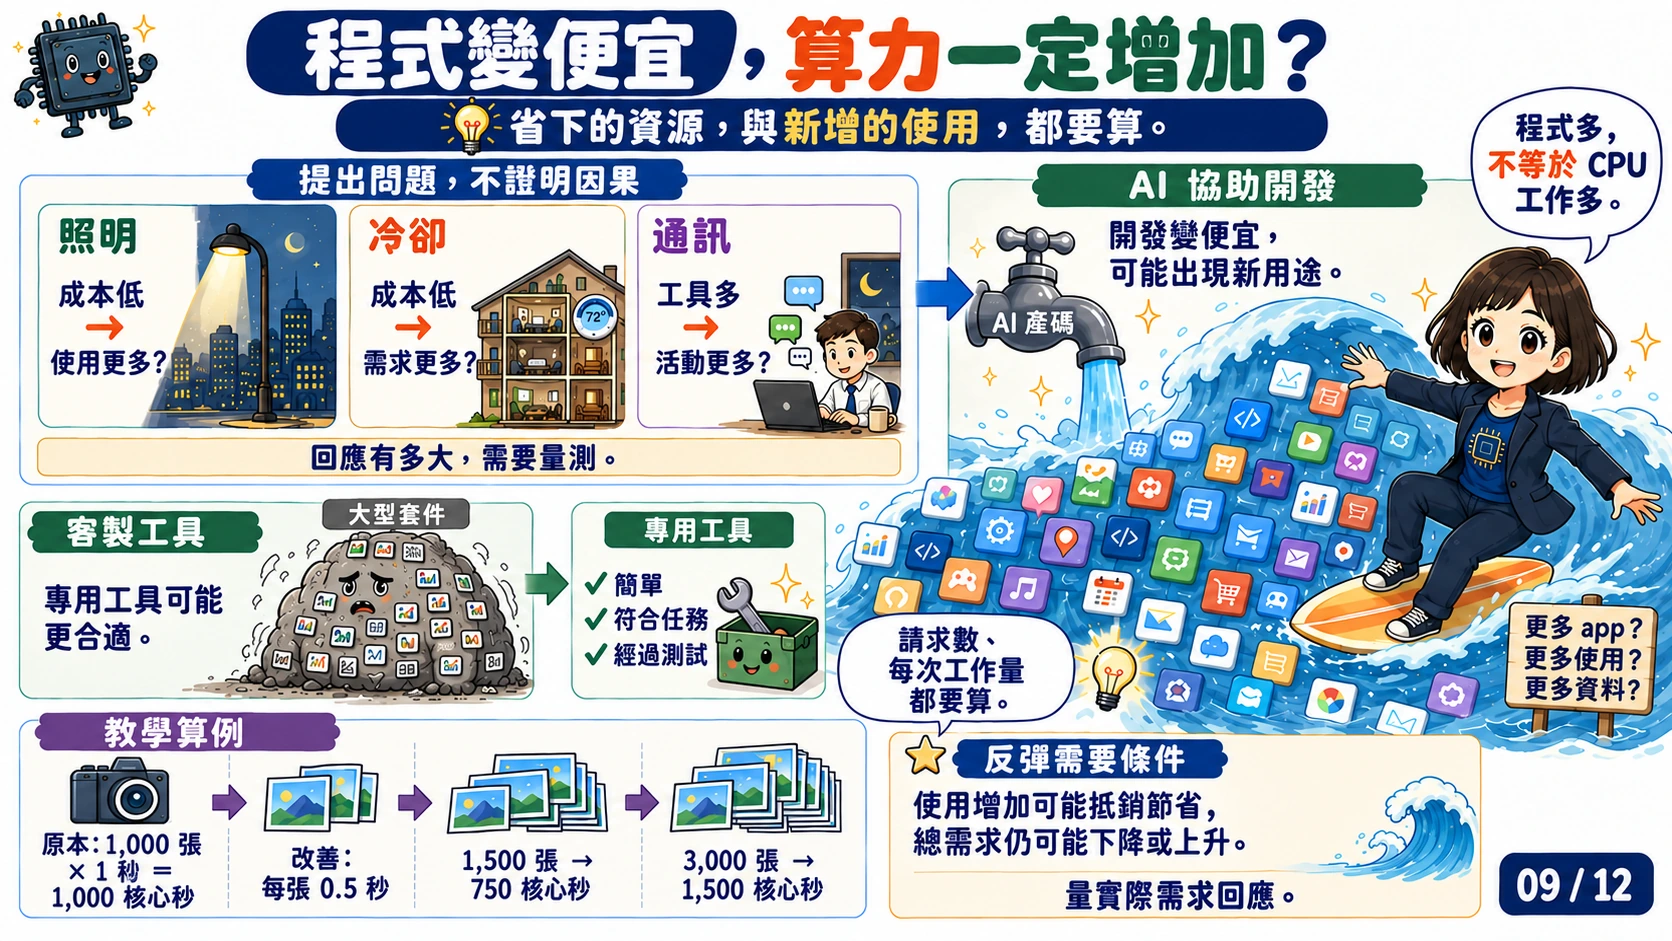
工作室原本覺得客製工具太貴,只替少數流程寫程式。開發成本若下降,就可能願意做更多小工具,例如自動整理檔名或檢查交付格式。這是需求可能擴張的原因。新增程式會不會經常執行、用多少運算資源,則是另一個問題。產生更多程式碼,不等於立刻產生同樣比例的 CPU 需求。
效率改善後,使用增加抵銷部分資源節省,稱為反彈效果。如果增加的使用超過原本節省,總資源消耗反而上升,才是通常所說的 Jevons 式結果。反彈可以只發生一部分,也可能沒有超過節省。因此「效率提高,總消耗必然增加」不是這個概念的保證。經濟研究也把需求回應列為需要分析的條件。[8]
用同一份照片工作算一次。原本每張需一秒,一天處理 1,000 張,合計 1,000 核心秒。改善後每張半秒,若每天改成 1,500 張,總需求是 750 核心秒,仍比原本少。若增加到 3,000 張,就變成 1,500 核心秒。這些是教學數字:單件效率相同,但需求回應不同,就得到不同的總量。
AI 降低部分開發工作的成本,可能打開原本不值得做的用途;也可能產生低使用率的工具,或讓既有程式更有效率。圖中的照明、空調與通訊例子只能提示問題,不能證明這些生活變化由效率改善造成。評估伺服器需求時,應量實際請求數與每件工作的成本,再分開估算兩者如何變化。
強核心、多核心與成本,如何一起選?
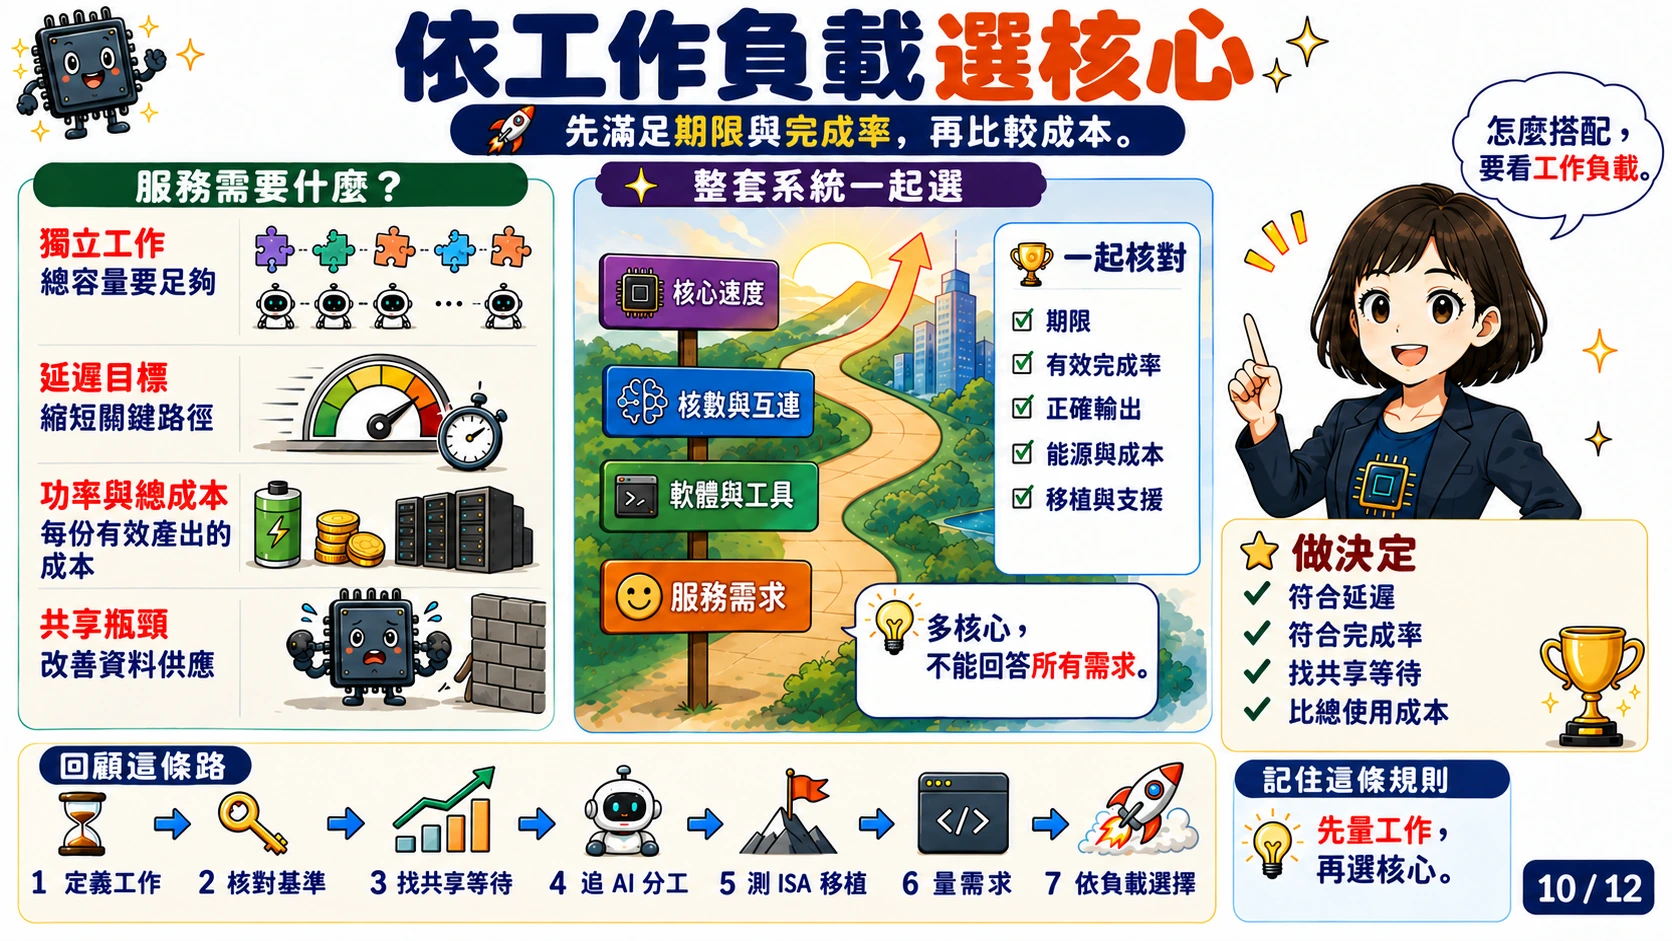
回到兩台每秒都能完成八張照片的機器。A 的單張運算需半秒,B 需一秒。若客戶要求照片送入後 0.75 秒內交付,即使暫不計排隊,B 也不符合要求。若只是夜間批次,能在清晨以前完成就好,B 可能仍是合適候選。哪種核心設計有價值,由服務條件決定。
機器還有成本差異。假設在同一份持續負載下,A 的整機功率為 200W,B 為 120W。兩者都每秒八張,A 每張用能約 25J,B 約 15J。這是固定品質、相同吞吐下的教學算例,不是產品實測。B 的能源表現較好,也不會消除前述延遲限制。
總擁有成本(TCO)把購入與長期使用一起考慮。除了電力,還有維護、軟體與部署成本。總成本再除以期間內完成的合格工作量,才能比較每件交付的成本。若某台機器需要額外移植,或更多台才能符合期限,這些成本都要算進去。峰值跑分或一個每瓦分數,不足以替代整體計算。
因此每核能力與核心數需要一起配置。串行關鍵路徑需要較短延遲;大量獨立工作則需要足夠總容量。共享資料通道不足時,改善核心未必改善服務。只看每核速度,或只看核心數,都會漏掉這些條件。本課的設計判斷是先符合服務要求,再比較有用吞吐與成本;它不預設所有工作都該選少數大核心。
回到工作室:先改善哪一個瓶頸?
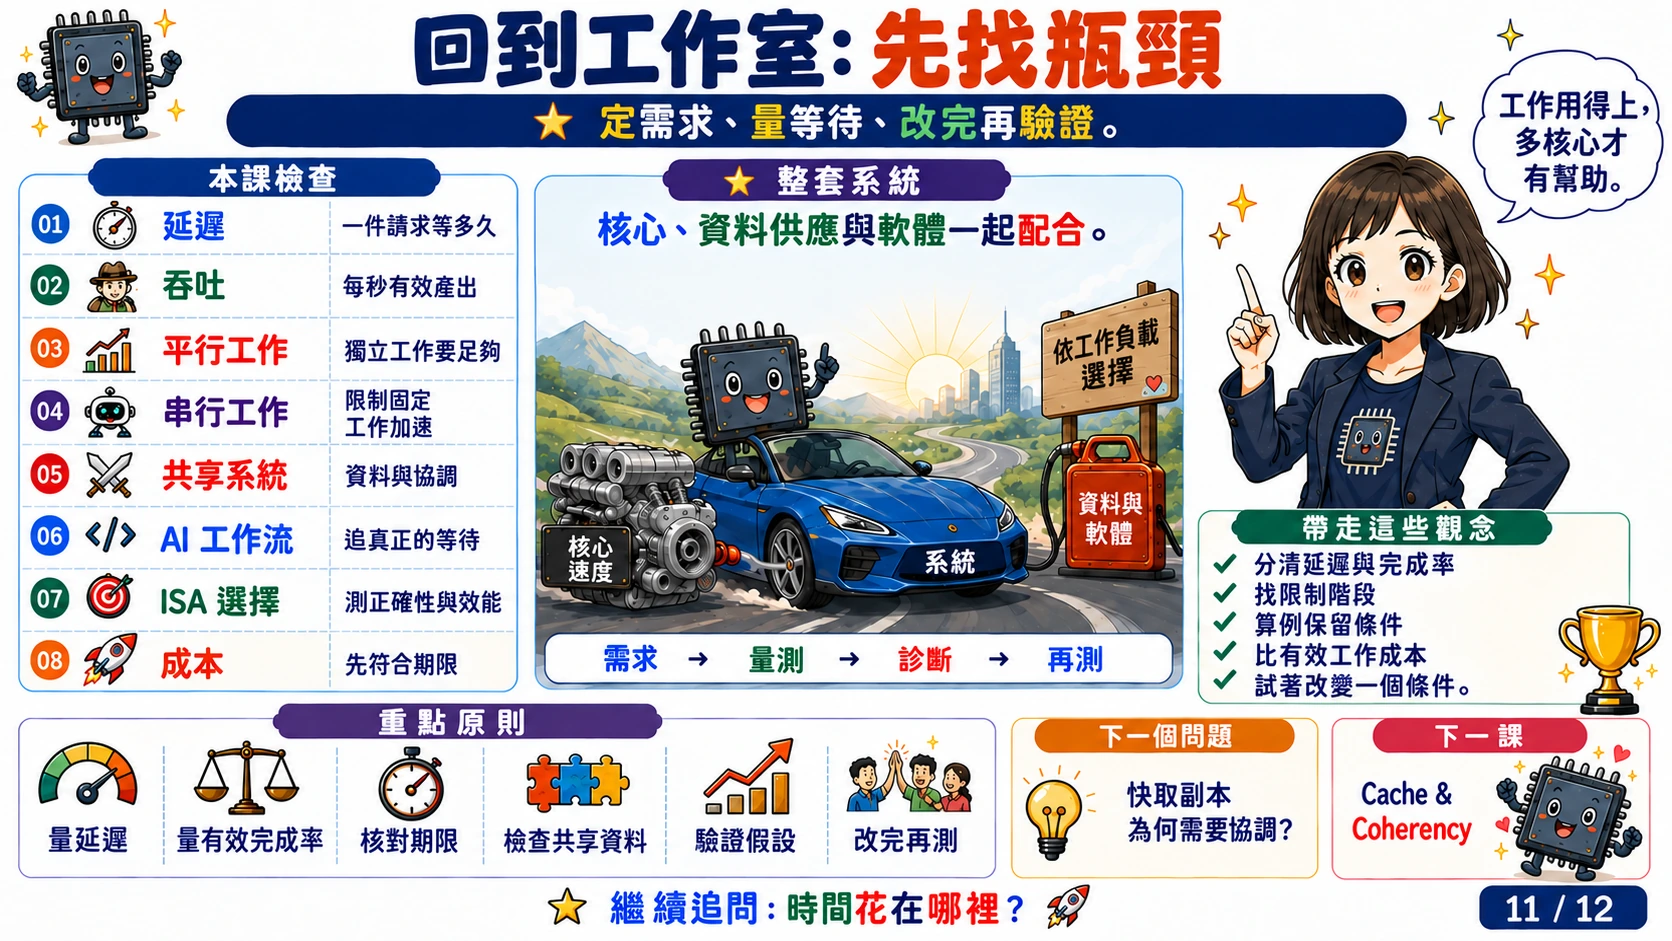
工作室現在可以把選機器的問題寫清楚。先定義照片品質與單張交付期限,再定義一天的工作量。測試時分開記錄單張運算、排隊等待與總完成率。若頻率相同但轉檔時間不同,上一課的 IPC 與資料等待提供分析方向。若加核後完成率沒增加,本課的共享瓶頸與平行工作提供下一步檢查。
若每核都有獨立照片,記憶體也能供應,增加核心可提高容量。若所有照片都等同一個輸出階段,先改善這個階段。若只剩一顆核心處理最後的大圖,檢查工作切分。如果等待發生在遠端服務,就先量網路與外部回覆。相同的低吞吐現象,可能由不同原因造成;改善方案必須跟著原因走。
再換一個條件檢查理解。原本每張照片獨立,後來需要所有照片共同計算一份統計結果。各核可先算自己的部分,最後再合併。合併若變成很長的序列階段,就會限制整批完成時間。這時不能沿用原先的線性假設。你要先量這個新階段,才能決定加核是否仍有收益。
這一課沒有展開一致性協定的狀態轉移,也沒有推導排隊理論或評估個別產品。接下來可讀 Cache & Coherency 小教室:多顆核心持有同一份資料時,為何仍需要通訊?先把這個問題接起來,就能理解某些等待為什麼無法單靠加核心消除。
本課重點回顧
- 延遲量一件工作要等多久;吞吐量量單位時間完成多少件。
- 獨立工作可以同時執行,串行共同階段與共享資源仍會限制擴充。
- 公開綜合分數提供線索,不能換算成產品等價或每秒交付量。
- AI 系統要找真正的供應關鍵路徑,不能假設 CPU 一停,所有 GPU 都停。
- 選擇核心設計前,先核對品質、期限與成本。
Hashtags
#CPU #MultiCore #Throughput #Latency #Amdahl #Scalability #AgenticAI #RISCV #TCO
References
- SPEC CPU2017 Overview — SPECspeed/SPECrate、工作負載與比較條件。
- PassMark PerformanceTest — CPU Benchmark — 分數的測試與彙整方法;不重建舊圖點位。
- Hill & Marty (2008), Amdahl’s Law in the Multicore Era — 固定工作量、串行比例與多核設計的分析。
- NVIDIA CUDA Programming Guide — Asynchronous Execution — 主機與裝置重疊執行的條件。
- RISC-V International FAQ — ISA 開放與實作 IP 成本的區分。
- GCC — RISC-V Options — ISA 擴充與 ABI 目標設定。
- RISC-V — RVWMO Memory Consistency Model — RISC-V 自己的排序規則,並非 Arm 模型的同義詞。
- Chan & Gillingham (2015), The Microeconomic Theory of the Rebound Effect and Its Welfare Implications — 能源反彈的需求分析;對軟體的應用是本課條件式類比。
- Debbie Marr,Computing at the Crossroads: Architecture, Economics, and the Next Era,ISCA 2026 官方議程。內容核對使用本次提供的兩份演講字幕:第一份 25:15–25:43(配比)、26:10–26:28(四倍至八到十倍的核心需求預測)、42:18–42:50(核心數比較)、48:37–48:59(移植)、54:39–54:57(記憶體模型)。時間從該字幕檔起點計算;議程連結確認場次,並非演講逐字稿。字幕有辨識錯誤,不把模糊片段當成已核對的原音。
- Google — Using AI and automation to migrate between instruction sets — 超過三萬個應用程式移植到 Arm;保留 x86 與 Arm 雙架構,不是 RISC-V 移植統計。
- RISC-V — Code Porting and Mapping Guidelines — 官方解說的 Arm→RVWMO 操作映射;解說並非規範正文,不能把兩套模型直接視為相同。
認識真正的 CPU 大師:Debbie Marr
About the author|原演講作者/講者介紹
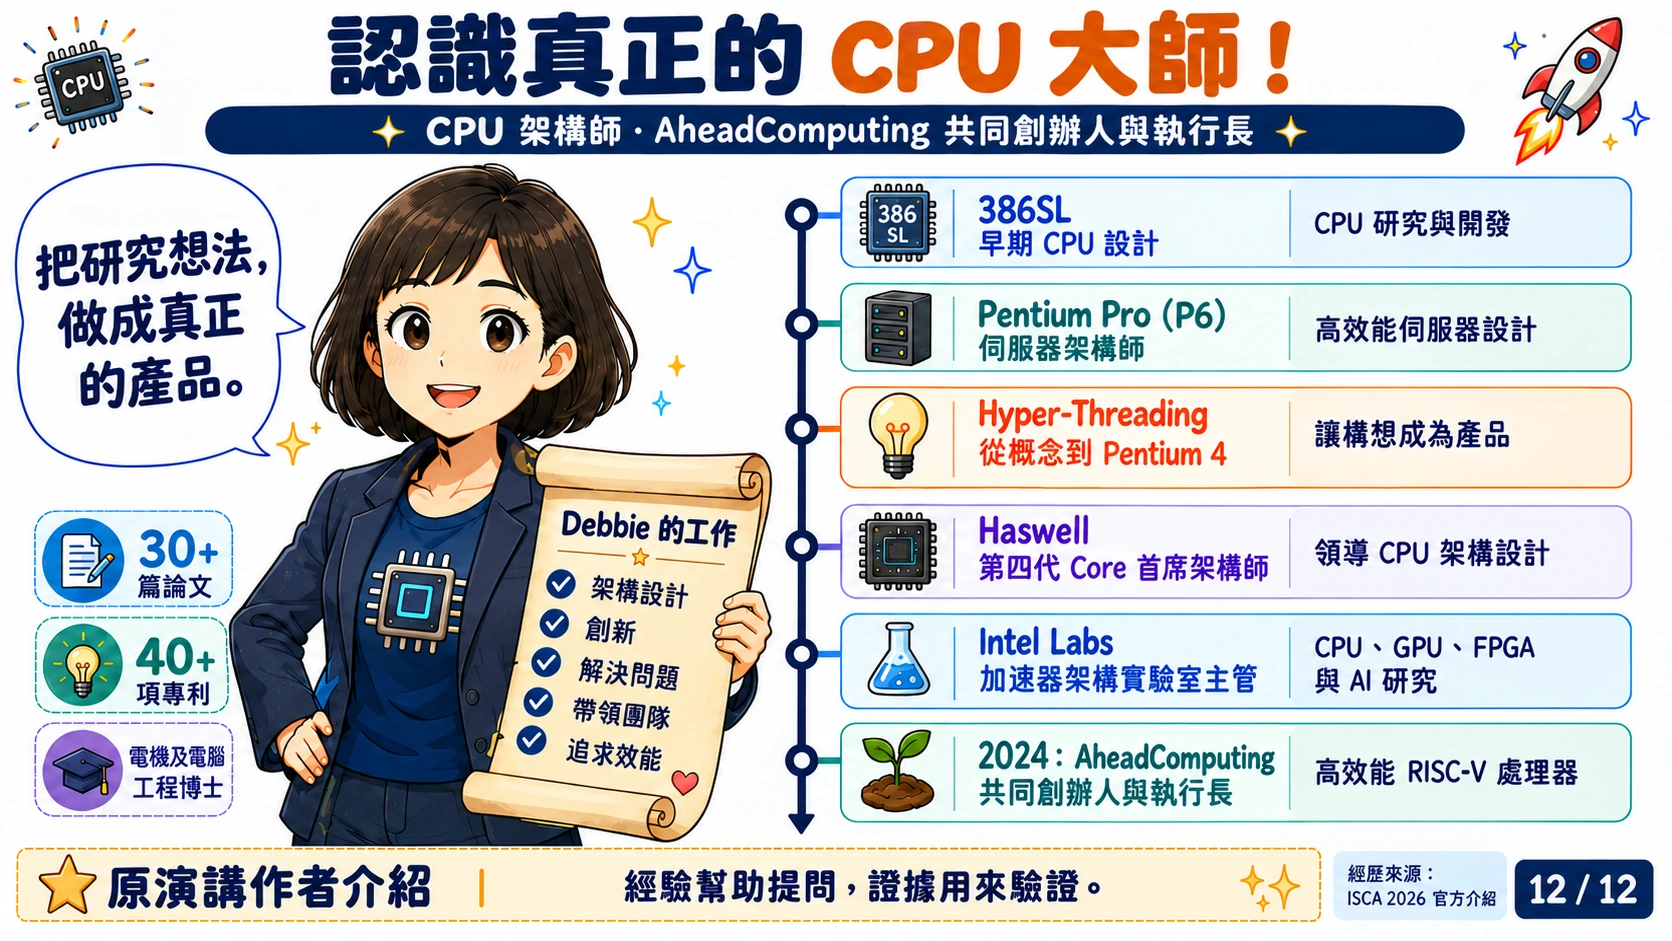
Meet the true CPU great master! Debbie 的觀點來自長期的設計經驗。ISCA 官方介紹記載,她在 Intel 投入 CPU 研發超過三十年,擔任 Pentium Pro 伺服器架構師,推動 Hyper-Threading 到 Pentium 4 產品,並任 Haswell 首席架構師。她也領導過 Intel Labs 加速器架構實驗室。[9]
官方資料列出超過三十篇論文、四十項專利與電機及電腦工程博士學位。她於 2024 年共同創辦 AheadComputing,任執行長。這些經歷值得認識;演講中的預測仍要與量測、規格分開看。本篇由 MY Academy 整理與延伸,不代表 Debbie 對本教材的背書。
學習指南
CPU 小教室系列
先備知識
- 單核 IPC 與等待的基本概念
- 獨立工作可以同時執行
我學會了什麼
- 區分延遲、整批加速與服務吞吐
- 計算固定工作量的 Amdahl 算例,並診斷共享瓶頸
- 區分綜合分數、應用吞吐與產品等價
- 依延遲與成本條件選擇每核能力和核心數